Programación de IA local en una GPU de 16 GB: Strata, OpenCode y Qwen3.8
Table of Contents
Un agente de programación local en una GPU de 16 GB es una opción práctica para tareas de desarrollo acotadas. Strata y OpenCode combinan la inferencia local con la edición de archivos, los comandos de shell y la ejecución de pruebas. Una ejecución publicada de Qwen3.8-Flash-Next en una RTX 4060 Ti completó una aplicación, cambios posteriores y un prototipo de juego de carreras sin llamadas de inferencia de pago.
Sustituir una suscripción requiere una prueba más amplia. Los resultados publicados muestran una configuración funcional en una máquina. No demuestran paridad con servicios de programación de pago entre lenguajes, repositorios o tareas difíciles de depuración. El hardware también incluye 64 GB de RAM del sistema, que contiene buena parte del modelo.
Puntos clave
- 16 GB describe la memoria de la GPU, no la memoria total necesaria para la configuración publicada.
- La reutilización del prompt importa porque los agentes de programación envían repetidamente historiales de conversación superpuestos.
- El razonamiento necesita un presupuesto para que la planificación deje espacio para el código y las llamadas a herramientas.
- Pasar pruebas generadas es una evidencia parcial, y Docker y el juego requieren comprobaciones separadas.
- El gasto cero en API excluye los costes de propiedad, la electricidad y el tiempo de mantenimiento.
Requisitos previos: Un ordenador compatible, suficiente almacenamiento libre para el modelo seleccionado, Git, Node.js con npm y familiaridad con herramientas de terminal. Iguala la configuración IQ3_S publicada con 64 GB de RAM. Usa el instalador actual de Strata para comprobar otras configuraciones.
Tiempo y dificultad: Intermedio. Reserva tiempo para descargar e instalar modelos grandes antes de evaluar la velocidad de finalización de tareas. Los tiempos publicados de las tareas excluyen la configuración.
La configuración probada
| Componente | Configuración publicada |
|---|---|
| GPU | NVIDIA RTX 4060 Ti, 16 GB de VRAM |
| CPU | Intel Core i5-11600K |
| Memoria del sistema | 64 GB de RAM |
| Almacenamiento | SSD NVMe |
| Modelo | Qwen3.8-Flash-Next, 125B MoE, IQ3_S |
| Motor de inferencia | Strata |
| Agente de programación | OpenCode |
| Contexto configurado | 65.536 tokens |
| Límite de salida configurado | 16.384 tokens |
La configuración y los resultados publicados por NetworkCoder proporcionan estas cifras. El repositorio de pruebas informa de la carga de 46.84GiB de pesos de expertos en 28 segundos, con 4.431 expertos ocupando 8.45GiB de memoria de GPU. Estas mediciones describen la ejecución probada, no una asignación garantizada en otra versión del motor.
La compatibilidad actual es más amplia que esta prueba. Según la comprobación del 6 de octubre de 2026, el proyecto Strata documenta tarjetas NVIDIA y AMD seleccionadas con al menos 12 GB de VRAM, además de modelos más pequeños para sistemas con 32 GB de RAM. Esas opciones no reproducen el experimento con GPU de 16 GB, RAM de 64 GB e IQ3_S. Comprueba la GPU exacta, la variante del modelo y el soporte del runtime antes de comprar hardware.
Dónde vive el modelo
La mezcla de expertos, o MoE, activa un subconjunto de las redes expertas de un modelo para cada token. Esto reduce el cálculo activo frente a usar todos los parámetros en cada paso. Los pesos restantes siguen necesitando almacenamiento y una ruta hacia el cálculo.
La ejecución híbrida de Strata mantiene en la GPU los expertos usados con frecuencia y conserva la colección de expertos en la RAM del sistema. La CPU calcula los expertos no almacenados en caché, mientras la GPU procesa los expertos almacenados. El almacenamiento también admite archivos del modelo y datos de consulta. El sistema no introduce todo el modelo 125B en 16 GB de VRAM.
La memoria de la GPU tiene usos que compiten. Las asignaciones del runtime, el estado de atención y la caché de expertos comparten un recurso limitado. Más espacio para el contexto cambia la capacidad restante de la caché de expertos. Las versiones actuales de Strata también admiten streaming de la caché KV, por lo que la ubicación exacta difiere de una configuración anterior. Consulta la documentación técnica para tu versión del motor.
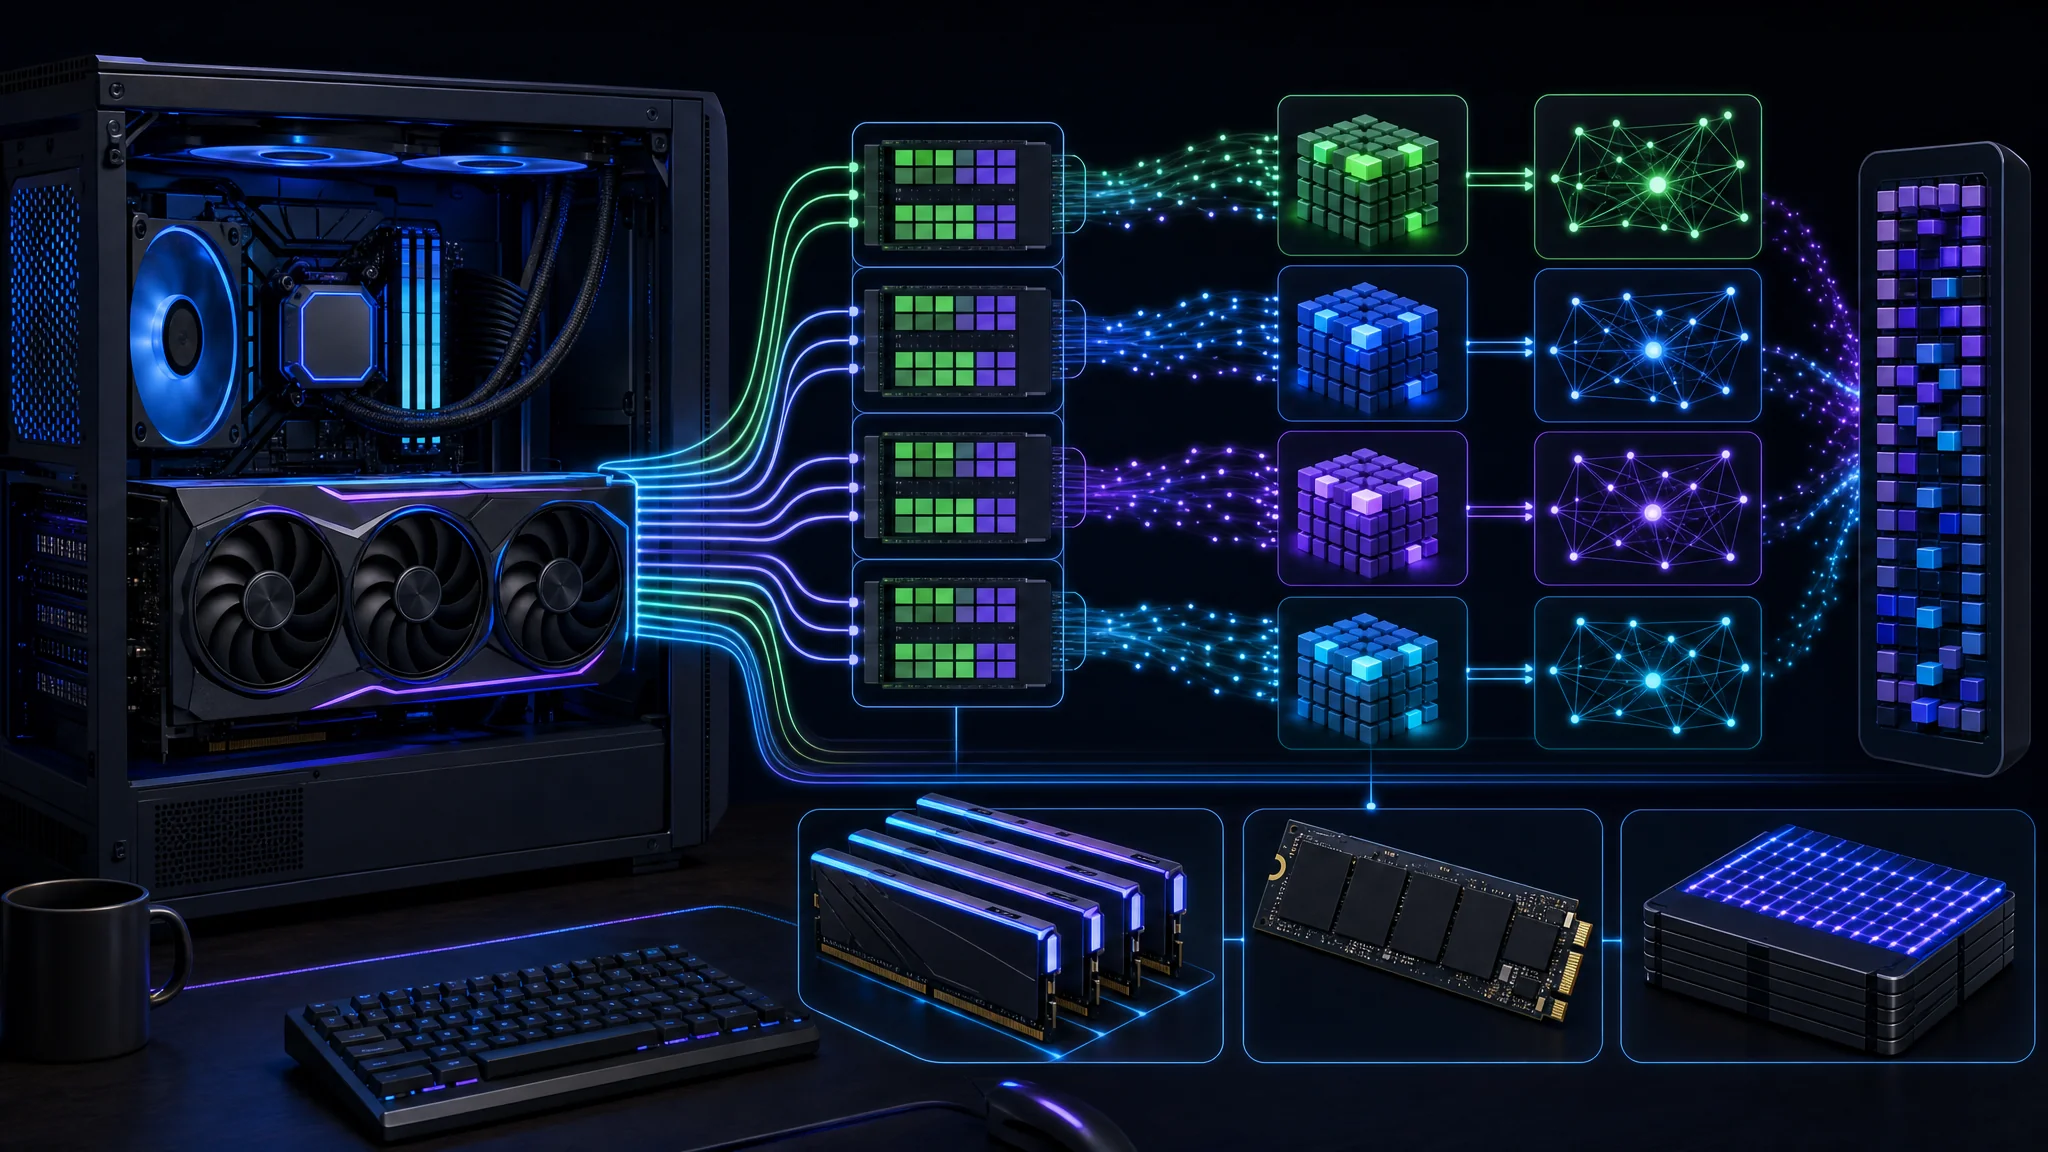
La GPU es una parte del sistema de inferencia, junto con la ejecución de la CPU, la RAM del sistema y el almacenamiento
La reutilización del prompt cambia la velocidad
Un agente de programación ejecuta un bucle: lee la tarea, solicita una acción de herramienta, recibe el resultado y decide la acción siguiente. El contenido de los archivos, los errores y los resultados de las pruebas se acumulan en la conversación. Los agentes también compactan o seleccionan el contexto, por lo que cada implementación no reenvía para siempre todo el historial sin cambios.
El prellenado procesa los tokens de entrada antes de la generación. La decodificación produce la respuesta. Un sistema con decodificación rápida pero con un prellenado repetido lento te hace esperar entre llamadas a herramientas.
El tiempo publicado para 44K tokens usó reutilización de prefijos. Strata reutilizó contenido de conversación procesado anteriormente, con el prompt creciente listo en aproximadamente uno a tres segundos. Es una evidencia útil para una sesión de agente continua. No demuestra procesar 44.000 tokens completamente nuevos desde cero en un segundo.
| Medición | Qué registrar |
|---|---|
| Prompt frío | Tiempo para contenido nuevo sin estado de prefijo reutilizable |
| Continuación cálida | Tiempo después de añadir el resultado de una herramienta al contexto existente |
| Velocidad de generación | Tokens por segundo durante la respuesta |
| Duración de la tarea | Planificación, generación, herramientas, pruebas y reintentos juntos |
Dos cachés cumplen funciones distintas. La caché de expertos mantiene los pesos usados con frecuencia cerca del cálculo de la GPU. La reutilización de prefijos evita repetir el trabajo de entradas anteriores. Una alta tasa de aciertos de la caché de expertos no demuestra un acierto de la caché de prompts.
Qué demostraron las tareas
| Tarea | Tiempo publicado | Resultado publicado |
|---|---|---|
| Crear un gestor de tareas | 3m 38s | API Express, interfaz, 5/5 pruebas |
| Corregir la edición y añadir fechas | 4m 58s | Cambios completados, 6/6 pruebas |
| Añadir exportación/importación y empaquetado | 3m 48s | 7/7 pruebas, compilación de Docker sin verificar |
| Juego de carreras, primer intento | 6m 35s | La salida se agotó durante el razonamiento, sin código |
| Juego de carreras, reintento presupuestado | 4m 51s | Juego generado, sintaxis de JavaScript comprobada |
El archivo de resultados publicado registra velocidades de salida de 48–52 tokens por segundo para la primera tarea, 40–43 para la segunda y 37–44 para la tercera. “Hasta 52” es un máximo dentro de estas observaciones, no una tasa sostenida para cada tarea.
Las tres primeras tareas amplían una aplicación. Los conteos 5/5, 6/6 y 7/7 describen suites de pruebas sucesivas. Sumarlos no demuestra 18 capacidades independientes. Las pruebas escritas por el mismo agente también requieren una revisión de cobertura y de aserciones significativas.
La recuperación del entorno formó parte del trabajo. El agente se recuperó de un comando de shell inadecuado e identificó un servidor de aplicaciones obsoleto durante las pruebas. Son comportamientos útiles, aunque terminar un proceso existente requiere permisos deliberados en un entorno de desarrollo compartido.
Docker quedó sin verificar. El agente escribió un Dockerfile, pero no tenía un motor Docker en ejecución para la compilación. Pasar las pruebas de la aplicación fuera del contenedor no demuestra que exista una imagen funcional. El reintento del juego también comprobó la sintaxis y abrió un navegador, mientras el agente carecía de confirmación visual directa del juego.
Reserva espacio para la salida
{
  "reasoning_budget_tokens": 8000
}
Integra esta configuración en la configuración existente strata-iq3_s.json, conserva sus otros campos y reinicia el modelo Strata seleccionado. Es una configuración de Strata, no un archivo de configuración sustituto de OpenCode. Verifica el presupuesto activo en la salida de inicio.
Strata documenta un presupuesto de razonamiento estricto que termina la fase de pensamiento y pasa hacia una respuesta. Un valor por solicitud sustituye el valor predeterminado configurado. La configuración es distinta de una instrucción general de esfuerzo de razonamiento como bajo o alto.
El primer intento del juego agotó su asignación de 16.384 tokens durante la planificación. El reintento aplicó un presupuesto de pensamiento de 8.000 tokens y entregó código. Esto respalda el uso de una fase de razonamiento acotada para esta carga de trabajo. No demuestra que 8.000 sea la mejor configuración para cada tarea.
La asignación de salida restante es un máximo, no una garantía de reserva. Si un límite de 8.000 tokens se consumiera por completo dentro de un límite total de 16.384 tokens, quedarían unos 8.384 tokens antes de otros gastos. El registro de resultados informa de 11.054 tokens escritos en el reintento sin un desglose completo entre razonamiento y código. No lo interpretes como 8.000 tokens de razonamiento más 11.054 tokens de código dentro del mismo límite.
Usa un presupuesto menor para ediciones acotadas y prueba presupuestos mayores para tareas que necesiten más análisis. Inspecciona la salida completa del archivo, el estado de finalización y los resultados de las pruebas. Más tiempo de planificación solo sirve si mejora el cambio entregado.
Conecta Strata y OpenCode
git clone https://github.com/Niko1221/Strata.git
cd Strata
./setup.sh
Este es el punto de entrada de configuración para Linux. Revisa las instrucciones de instalación actuales y usa START-HERE.bat para la ruta documentada de Windows. Selecciona la variante original Qwen3.8-Flash-Next IQ3_S y un contexto de 65.536 tokens para aproximar la configuración publicada. Guarda la versión del motor y los archivos de modelo seleccionados con tus notas del benchmark.
npm install -g opencode-ai
Instala OpenCode con las
instrucciones oficiales
. En un terminal separado, define STRATA_BASE_URL como la base de la API local que muestra Strata, incluido el sufijo /v1. Mantén la inferencia vinculada a la máquina local para esta configuración.
{
  "provider": {
    "strata": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Strata local",
      "options": {
        "baseURL": "{env:STRATA_BASE_URL}",
        "apiKey": "local"
      },
      "models": {
        "qwen3.8-flash-next-iq3_s": {
          "name": "Qwen3.8-Flash-Next IQ3_S",
          "limit": { "context": 65536, "output": 16384 }
        }
      }
    }
  },
  "model": "strata/qwen3.8-flash-next-iq3_s"
}
Integra el bloque del proveedor en ~/.config/opencode/opencode.json, conservando la configuración existente. Esto adapta el
ejemplo de configuración publicado
cargando el endpoint local desde una variable de entorno. OpenCode documenta los
proveedores personalizados
y la
sustitución de entorno
.
local es una credencial de sustitución, igual que la configuración local sin autenticación del ejemplo. No protege un servidor. Si tu instancia de Strata activa la autenticación, proporciona la credencial configurada mediante el mecanismo local de secretos adecuado.
Inicia opencode en una copia desechable del proyecto y selecciona el modelo configurado. Verifica el proveedor seleccionado antes de enviar código. La declaración de contexto del cliente no aumenta el contexto configurado del servidor, y una ventana de 65.536 tokens no deja 65.536 tokens para la entrada cuando también se necesita espacio para la salida.
Inferencia local y permisos
{
  "permission": {
    "edit": "ask",
    "bash": "ask"
  }
}
Integra estos permisos iniciales en la configuración de OpenCode mientras evalúas el agente. La documentación de permisos explica los controles disponibles. Los cambios de archivos y la ejecución de shell afectan a tu máquina sin importar dónde se ejecute la inferencia.
La inferencia local no hace que todas las herramientas sean locales. Las descargas de paquetes, las herramientas web, las integraciones externas y la compartición opcional implican servicios de red. Revisa las herramientas activadas antes de trabajar con repositorios privados. “El modelo se ejecuta localmente” es una afirmación más limitada que “nada sale del ordenador”.
Solución de problemas del primer arranque
| Síntoma | Comprueba primero |
|---|---|
| Proveedor no disponible | Strata se está ejecutando y la variable de entorno llega al proceso de OpenCode |
| Falta el modelo en la selección | El ID del proveedor y el ID del modelo coinciden con la configuración guardada |
| Error de límite de contexto | La longitud del prompt más la salida solicitada caben en la ventana activa del servidor |
| Planificación sin código | Presupuesto de razonamiento, límite total de salida y estado de finalización |
| Continuación lenta | Reutilización de prefijos, presión de memoria, comportamiento de la caché de expertos y procesos en competencia |
| Falla el comando de Docker | Hay un motor funcional, no solo su cliente de línea de comandos |
Cambia una configuración cada vez y repite la misma tarea desde un estado inicial guardado. Esto separa una mejora de configuración de un prompt distinto o una prueba más fácil.
¿Sustituye una suscripción?
| Vale la pena probar la configuración local | Mantén otra opción disponible |
|---|---|
| Hardware compatible existente | Comprar hardware solo para una carga de trabajo no probada |
| Cambios acotados en aplicaciones | Repositorios grandes desconocidos y migraciones difíciles |
| Pruebas de aceptación repetibles | Tareas sin formas fiables de comprobar la corrección |
| Tiempo para el mantenimiento del runtime | Trabajo que requiere poco setup y poca carga de soporte |
El gasto cero en API tiene importancia, sobre todo cuando el hardware ya está disponible. Excluye la electricidad, la depreciación del hardware, el almacenamiento y el tiempo de mantenimiento del entorno. El campo de coste cero mostrado tampoco mide esos gastos.
Una comparación de suscripciones necesita tareas equivalentes. Ejecuta el mismo repositorio inicial, las mismas instrucciones y las mismas comprobaciones de aceptación en ambos sistemas. Registra los reintentos y las correcciones humanas junto con el tiempo transcurrido. Incluye el primer intento fallido del juego al evaluar todo el flujo, en lugar de informar solo del reintento exitoso.
Un agente local útil no necesita superioridad universal. Si gestiona de forma fiable tus ediciones rutinarias y deja un conjunto pequeño de tareas difíciles para otra herramienta, ya cambia los servicios de pago que necesitas. Decide a partir del trabajo aceptado en tus propios proyectos.
Demostración y próximos pasos
Para ver después: La demostración del agente local de programación 125B . Las mediciones publicadas anteriores pertenecen a la prueba publicada, no a un benchmark independiente realizado para este artículo.
- Reproduce una tarea pequeña con criterios de aceptación fijos y una revisión inicial guardada.
- Mide turnos fríos y cálidos en vez de tratar la reutilización de prefijos como velocidad de prellenado en frío.
- Verifica el empaquetado por separado con una compilación de imagen exitosa, arranque y comprobaciones a nivel de contenedor.
- Inspecciona las pruebas generadas y añade casos que la implementación no anticipó.
- Compara el trabajo terminado con tu herramienta de programación actual antes de cambiar suscripciones.
Para planificar el hardware, lee la guía de modelos locales de IA y contexto de GPU . Para el comportamiento de modelos alojados, consulta el enrutamiento de proveedores y los costes de OpenRouter .
Related Posts