Enrutamiento de proveedores de OpenRouter: calidad del modelo, límites de tokens y costes reales
Table of Contents
El enrutamiento de proveedores de OpenRouter determina qué servicio de inferencia responde a tu solicitud. Dos llamadas con el mismo nombre de modelo siguen dependiendo de los límites del endpoint, los parámetros admitidos, el software de servicio y las preferencias de enrutamiento. Si las respuestas se acortan o fallan las llamadas a herramientas, revisa esas diferencias antes de culpar a la cuantización.
Puntos clave
- Las etiquetas de precisión describen un formato numérico, no una puntuación de exactitud.
- Los límites del endpoint determinan el contexto, la longitud de salida y el soporte de funciones.
- El enrutamiento explícito necesita una política de fallback además de la preferencia de proveedor.
- Auto Exacto mejora la selección mediante señales de calidad y ofrece una ruta opcional para solicitudes sin herramientas.
- El coste efectivo incluye salida, caché, reintentos y finalización correcta de la tarea.
Requisitos: Familiaridad con solicitudes JSON y acceso a la configuración de OpenRouter de tu aplicación. La inspección de endpoints usa una API pública. Enviar solicitudes de modelo requiere una clave de API y genera cargos. Vuelve a comprobar los metadatos antes de repetir un ejemplo fechado.
Tiempo y dificultad: Unos 20 minutos para una revisión inicial. Nivel intermedio. Una comparación útil entre proveedores requiere pruebas adicionales con prompts representativos.
Lo que omite el nombre del modelo
El identificador del modelo selecciona el modelo solicitado. El proveedor ejecuta el servicio de inferencia, incluida su implementación, los límites de tokens y el analizador de llamadas a herramientas. Un benchmark del modelo no valida todos los servicios que alojan esos pesos.
| Propiedad del endpoint | Qué comprobar |
|---|---|
| Longitud del contexto | Espacio para prompt, historial, resultados de herramientas y generación |
| Longitud máxima de completion | Límite de salida para la tarea |
| Parámetros admitidos | Herramientas, salida estructurada, muestreo y controles de razonamiento |
| Cuantización | Formato declarado frente a la versión original |
| Precios | Entrada, salida, lecturas de caché y cargos adicionales |
| Comportamiento del servicio | Calidad de completion, errores de análisis, latencia y reintentos |
El enrutamiento básico favorece precios bajos entre candidatos sanos. OpenRouter documenta una ponderación inversa al cuadrado del precio. En su ejemplo simplificado, un candidato de 1 dólar recibe nueve veces el peso de selección de uno de 3 dólares. Son pesos relativos, no una garantía para la próxima solicitud. El orden explícito, la clasificación, la caché y el enrutamiento por calidad también influyen. Consulta la documentación de enrutamiento de proveedores .
La ponderación por precio no demuestra la factura más baja para tu carga. El ejemplo no define una mezcla universal de entrada y salida. No infieras la probabilidad de seleccionar un proveedor a partir del precio de entrada solamente.
Lee la precisión en contexto
La cuantización almacena valores numéricos con una representación reducida. Su efecto depende del modelo, el método y la implementación de inferencia. La menor precisión exige pruebas, pero la etiqueta sola no demuestra que el proveedor haya cambiado los pesos originales.
GPT-OSS ofrece un ejemplo concreto. La documentación de lanzamiento de gpt-oss-120b de OpenAI indica que los pesos expertos de mezcla de expertos usan MXFP4 y que las evaluaciones usaron la misma cuantización. Una etiqueta de cuatro bits es coherente con esa versión publicada. No demuestra una degradación adicional del proveedor.
El upcasting convierte valores almacenados en una representación más amplia. Convertir un checkpoint ya cuantizado a BF16 no recupera la información descartada. Convertir un checkpoint original de mayor precisión a cuatro bits introduce otro cambio que merece evaluación.
| Observación | Conclusión respaldada |
|---|---|
| Checkpoint MXFP4 nativo | Los pesos expertos de cuatro bits pertenecen a la versión |
| Etiqueta BF16 del endpoint | Formato declarado más amplio, sin prueba de mejores respuestas |
| Precisión desconocida | Metadatos ausentes, sin prueba de degradación oculta |
| Etiquetas de precisión iguales | Evidencia insuficiente de comportamiento equivalente |
Las etiquetas iguales tampoco descartan diferencias de cuantización. No indican qué tensores se cuantizaron, qué calibración se usó ni qué kernels ejecutan. Prueba el endpoint completo en lugar de tratar la profundidad de bits como una clasificación de calidad.
Comprueba el presupuesto de tokens
curl --fail --silent --show-error \
  'https://openrouter.ai/api/v1/models/openai/gpt-oss-120b/endpoints' \
  | jq '.data.endpoints[] | {
      name,
      provider_name,
      context_length,
      max_completion_tokens,
      supported_parameters,
      quantization,
      pricing
    }'
La API de endpoints expone metadatos del proveedor para un modelo. Este comando necesita curl y jq. Inspecciona la
respuesta actual del endpoint gpt-oss-120b
antes de elegir un servicio. Trata los campos ausentes o nulos como desconocidos, no como ilimitados. Guarda una instantánea local con fecha para comparar resultados.
Una comprobación del 5 de octubre de 2026 devolvió estos límites anunciados para gpt-oss-120b. Son valores de metadatos, no longitudes de completion medidas, y los proveedores los cambian con el tiempo.
| Proveedor | Tokens de contexto | Máximo de tokens de completion |
|---|---|---|
| DigitalOcean | 128,000 | 4,096 |
| Novita | 131,072 | 32,768 |
| Together | 131,072 | 117,964 |
La longitud del contexto y la de salida son límites separados. Un modelo de contexto largo aún necesita espacio para su respuesta. El historial, las instrucciones del sistema y las definiciones de herramientas consumen espacio junto con el documento.
Los tokens de razonamiento también consumen presupuesto en modelos compatibles. Una asignación pequeña arriesga razonamiento incompleto, poca salida visible o finalización antes de la respuesta final. Inspecciona el uso y la razón de finalización. OpenRouter explica esta asignación en su documentación de tokens de razonamiento .
Un max_tokens explícito ofrece al router una longitud solicitada para compararla con el soporte del proveedor. Elígelo según las necesidades medidas y el contexto disponible. Un valor excesivo reduce la elegibilidad y no garantiza una respuesta más larga o mejor.
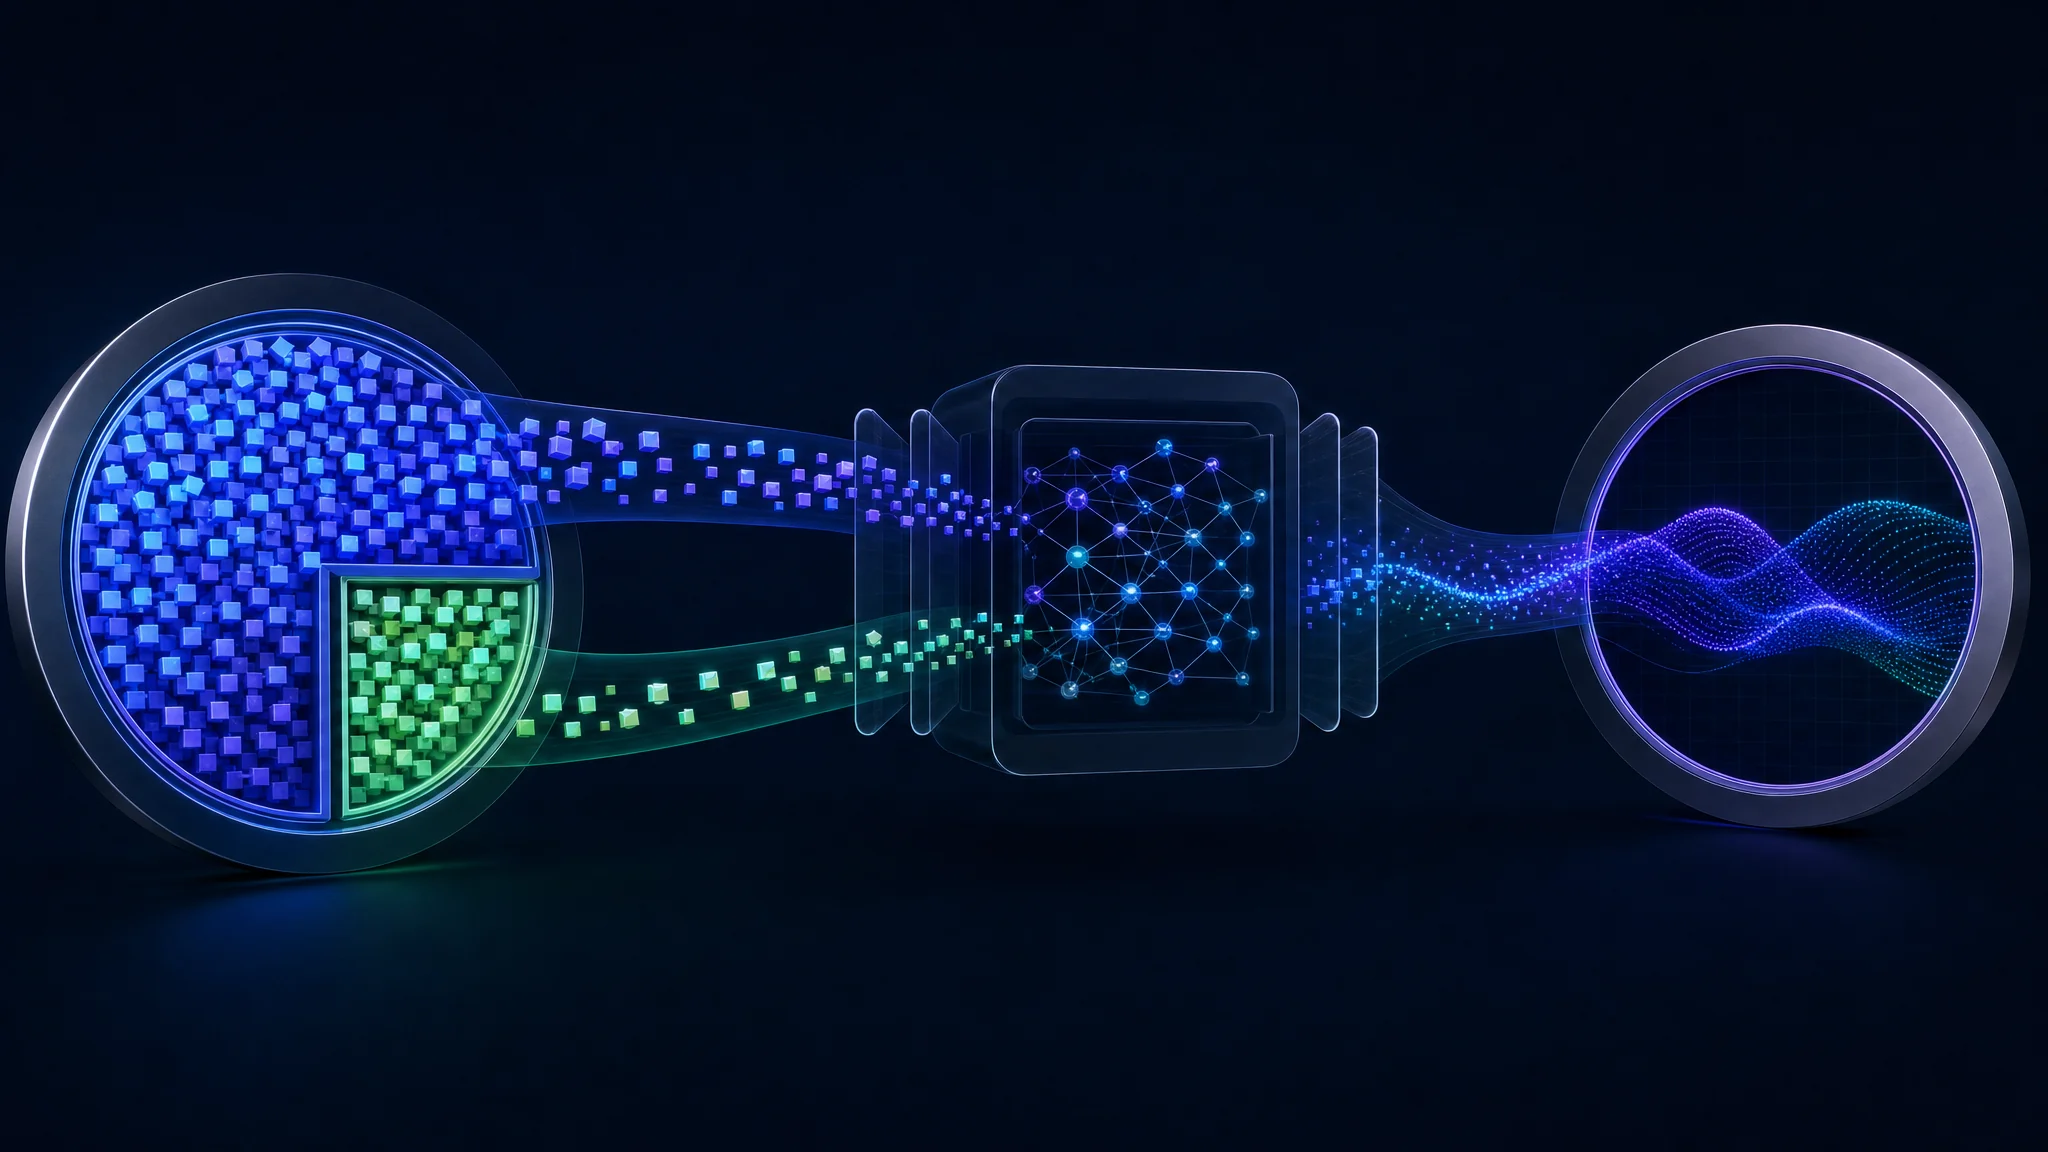
Conceptual token allocation, with reasoning and visible output sharing the completion allowance on supported providers
Exige tus parámetros
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Explain the failure modes of a retry loop."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
require_parameters tiene false como valor predeterminado. Con el enrutamiento predeterminado, los parámetros no admitidos no siempre excluyen un endpoint. OpenRouter documenta que los proveedores ignoran parámetros desconocidos. Al poner true, el enrutamiento se filtra por soporte declarado.
Los metadatos de soporte no garantizan el comportamiento. Un endpoint que anuncia soporte de seed aún necesita pruebas de reproducibilidad. Uno capaz de usar herramientas necesita validación de esquema y pruebas de aplicación. El filtro evita incompatibilidades conocidas.
Fija proveedores de forma deliberada
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Summarize the supplied incident report."}
  ],
  "max_tokens": 8192,
  "provider": {
    "order": ["REPLACE_WITH_VERIFIED_PROVIDER_SLUG"],
    "allow_fallbacks": false,
    "require_parameters": true
  }
}
Sustituye el marcador por el slug del proveedor copiado de la lista del modelo. Envía el informe en la solicitud real. La plantilla sirve para revisar la configuración y no es ejecutable hasta sustituirlo.
order establece una preferencia. Por sí solo deja activos los fallbacks. Combínalo con allow_fallbacks: false para limitar el enrutamiento a los proveedores listados. La solicitud fallará si ninguno satisface la petición o sigue disponible.
Las variantes del endpoint requieren atención. Un slug base coincide con varias variantes según las reglas documentadas. Usa el slug específico al probar una configuración concreta y vuelve a comprobar el proveedor de cada respuesta.
quantizations es una lista permitida de formatos con nombre, no un mínimo numérico. Un array con "fp8" selecciona endpoints FP8 coincidentes. No incluye BF16 automáticamente ni todos los formatos con más bits. Compara primero el checkpoint original y aplica el filtro solo si tu evaluación respalda la restricción.
Mantén activo el enrutamiento de calidad
{
  "model": "openai/gpt-oss-120b:exacto",
  "messages": [
    {"role": "user", "content": "Compare the two supplied incident reports."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
Auto Exacto usa rendimiento, telemetría de herramientas y benchmarks para reducir la prioridad de proveedores con bajo rendimiento. El anuncio de OpenRouter de marzo de 2026 informa una caída del 88% en errores de llamadas de herramientas de GLM-5, aproximadamente de 8% a 1%. Para gpt-oss-120b informa un cambio de 5.6% a 3.5%.
Son resultados comunicados por el proveedor, no una promesa para tu aplicación. La validez de una llamada mide JSON, nombres y esquemas. Una llamada sintácticamente válida aún necesita argumentos y acción correctos.
Las solicitudes con herramientas reciben Auto Exacto por defecto cuando el modelo tiene cobertura suficiente. Para otras solicitudes, :exacto activa el enrutamiento de calidad. La documentación actual lo respalda para resúmenes y chat, además del uso de herramientas.
sort: "price", el sufijo :floor y el orden de precio predeterminado de la cuenta desactivan Auto Exacto. Revisa juntos los ajustes de la aplicación y de la cuenta. Consulta la
documentación de Auto Exacto
antes de combinar controles.
Calcula el coste de tu carga
El precio de entrada solo ofrece una comparación incompleta. Estas tarifas ilustrativas están expresadas en dólares por millón de tokens. Muestran la aritmética, no cotizaciones actuales.
| Endpoint ilustrativo | Precio de entrada | Precio de salida |
|---|---|---|
| A | $0.03 | $16.00 |
| B | $0.42 | $1.32 |
Workload: 6 million input tokens + 1 million output tokens

A = 6 × $0.03 + 1 × $16.00 = $16.18
B = 6 × $0.42 + 1 × $1.32  =  $3.84

Per million combined input and output tokens:
A = $16.18 / 7 = $2.31
B =  $3.84 / 7 = $0.55
El endpoint A cuesta unas 4.2 veces más para esta mezcla pese a su menor precio de entrada. La proporción de precio de salida a entrada, 533 a 1 en A, relaciona dos tarifas. No es el multiplicador del coste total. Otras proporciones cambian la comparación.
Las unidades de precio de la API difieren de las tablas. La API expresa precios por token. Multiplica por un millón antes de compararlos con las tarifas anteriores.
La caché de prompts añade otra variable. Las lecturas y escrituras de caché y la entrada sin caché requieren cuentas separadas según las reglas del proveedor. El texto repetido no garantiza un acierto. Comprueba los recuentos y costes de tokens en la documentación de caché de prompts .
El enrutamiento afecta la continuidad de la caché. OpenRouter documenta el enrutamiento fijo para caché, mientras el orden manual tiene prioridad. Auto Exacto también reordena proveedores y a veces interrumpe una caché caliente. Compara el ahorro observado con los costes de calidad y reintentos antes de cambiar la política.
El coste por resultado aceptado es la métrica útil. Divide el gasto total, incluidos reintentos y fallos, entre resultados que cumplen tus criterios. Separa los cargos no relacionados con tokens. Una tarifa baja no compensa tareas fallidas repetidamente.
Diagnostica una respuesta inconsistente
| Síntoma | Primera comprobación |
|---|---|
| Respuesta corta o incompleta | Razón de finalización, límite de salida, uso de razonamiento |
| Detalles ausentes del documento | Contenido enviado, límite de contexto, truncamiento del cliente |
| Llamada de herramienta mal formada | Soporte anunciado, esquema, comportamiento del analizador |
| Muestreo diferente | Parámetros solicitados y soporte declarado |
| Gasto inesperado | Volumen de salida, lecturas de caché, reintentos y cambios de proveedor |
| Ningún proveedor elegible | Límites en conflicto, listas permitidas y restricciones de fallback |
Conserva el ID de generación que devuelve la respuesta. La API de metadatos de generación expone proveedor, uso, coste y finalización. El ID de sesión agrupa trabajo relacionado, pero no sustituye al ID de generación.
Guarda la solicitud junto al ID. Conserva modelo, preferencias, parámetros, marca de tiempo y uso de respuesta. Esto hace reproducible una comparación posterior cuando cambian precios, routing o metadatos.
Compara endpoints con condiciones iguales. Usa el mismo prompt, herramientas, ajustes de razonamiento y presupuesto. Repite varias tareas representativas. Separa respuestas incompletas, llamadas inválidas y respuestas incorrectas en vez de combinarlas en una puntuación sin explicación.
La incertidumbre del benchmark importa. El análisis de Epoch AI describe variación por implementaciones, muestreo y estructuras de agentes. Una respuesta decepcionante no demuestra un defecto persistente ni su causa.
Guía del enrutamiento de endpoints
Para ampliar: Debate sobre calidad y enrutamiento de endpoints de OpenRouter . Vuelve a comprobar las listas antes de aplicar precios, límites o comparaciones concretas.
Próximos pasos
- Inspecciona los endpoints de un modelo y anota los límites relevantes.
- Elige una política de enrutamiento con requisitos de parámetros y fallback explícitos.
- Prueba tareas representativas contra endpoints candidatos y routing de calidad.
- Registra el coste de resultados aceptados junto con latencia, caché y categorías de fallos.
- Vuelve a comprobar después de cambios en versiones, servicio o precios.
Para fundamentos de IA, continúa con Conceptos básicos de IA . Para permisos de agentes y controles de validación, lee Protección de sistemas de IA .
Related Posts