¿Son suficientes 16GB de VRAM para trabajar en serio con LLM locales?
Table of Contents
16GB de memoria GPU dedicada permiten trabajar en serio con LLM locales cuando el modelo, el contexto y el runtime encajan. Cargar los pesos solo cumple el primer requisito. Una configuración útil también necesita memoria suficiente para la conversación activa y velocidad suficiente para terminar la tarea.
Usa Qwen3.8 27B como ejemplo para presupuestar un flujo de código o documentos para un solo usuario. Empieza con el contexto que necesita la tarea. Después elige pesos y ajustes del runtime que encajen en la memoria restante. Las especificaciones de hardware y las fuentes del modelo se revisaron el 7 de octubre de 2026.
Puntos principales
- Reserva memoria para el contexto antes de elegir una cuantización.
- Mide el procesamiento del prompt por separado de la velocidad de salida.
- Desactiva el soporte de visión sin uso y prueba una caché KV de 8 bits.
- Compara la GPU, el backend, el archivo del modelo y la longitud del prompt exactos.
- Calcula el ahorro de propiedad según tu carga de trabajo y la factura del proveedor.
Para este ejercicio necesitas el registro de memoria del runtime, el nombre exacto del archivo del modelo y una tarea representativa. Reserva unos 20 minutos para la configuración y el registro de resultados, además del tiempo de inferencia. La dificultad es intermedia.
Ajusta la memoria al trabajo
16GB sirven para una carga cuyos pesos, contexto activo y asignaciones temporales permanecen dentro de la memoria GPU disponible. El contexto necesario depende de la tarea. Un resumen corto y un agente de código que lee decenas de archivos necesitan presupuestos diferentes.
| Carga de trabajo | Primera pregunta de dimensionamiento |
|---|---|
| Chat corto o redacción | ¿El modelo alcanza tu objetivo de calidad? |
| Análisis de documentos | ¿Caben juntos el texto fuente y la respuesta? |
| Agente de código | ¿Cuánto contexto consumen los archivos y resultados de herramientas? |
| Peticiones simultáneas | ¿Cuánta caché necesita cada sesión activa? |
Una ventana configurada difiere de una ventana ocupada. Un benchmark con límite de 64K y prompt corto no mide la generación después de 55K tokens de conversación. Prueba cerca de la longitud esperada de sesión antes de elegir hardware.
Por qué cabe el modelo
La cuantización guarda los pesos con menos bits. La tabla de archivos Qwen3.8 27B de Bartowski indica 17.44 GB para Q4_K_M, por encima de los aproximadamente 17.18 mil millones de bytes de un dispositivo de 16 GiB antes de añadir la memoria del runtime.
La ficha del modelo GSQ-RCO de ISTA-DASLab indica 11.8 GB para IQ3_S. El método asigna distintas precisiones a distintos tensores dentro de un presupuesto de tamaño. La versión MTP opcional añade unos 0.35 GB y el proyector de visión unos 0.9 GB.
| Benchmark publicado | Puntuación BF16 / IQ3_S |
|---|---|
| AIME25 | 100.00 / 100.00 |
| LiveCodeBench v6 | 85.71 / 85.71 |
| GPQA-Diamond | 89.90 / 89.39 |
El laboratorio llama a este punto de operación “task-lossless”. Estos resultados respaldan una comparación limitada. No demuestran respuestas idénticas, recuperación igual con contexto largo ni fiabilidad igual en tus tareas de código. Prueba el modelo comprimido con tus propios criterios de aceptación.
Cuenta la caché
La caché KV guarda las claves y valores de atención de los tokens ya procesados. El prompt, la salida de herramientas y las respuestas generadas consumen contexto. Algunos runtimes asignan la capacidad de caché al iniciar, por lo que la memoria mostrada no tiene que crecer con cada mensaje.
La configuración de Qwen especifica 64 capas, atención completa cada cuarta capa, cuatro cabezas KV y una dimensión de cabeza de 256. Para esas 16 capas de atención completa, el coste FP16 calculado es:
16 layers × 4 KV heads × 256 elements × 2 (K and V) × 2 bytes
= 65,536 bytes per token
= 64 KiB per token
Este cálculo excluye el estado recurrente, la alineación, los buffers temporales y las asignaciones de decodificación especulativa. Otras arquitecturas requieren cálculos diferentes.
| Tokens ocupados | Caché FP16 de atención completa |
|---|---|
| 32,768 | 2 GiB |
| 65,536 | 4 GiB |
| 131,072 | 8 GiB |
| 262,144 | 16 GiB |
Aquí KiB y GiB usan potencias de 1024. Las descargas de modelos usan GB decimales. Mezclar unidades distorsiona el presupuesto restante.
Presupuesta el contexto disponible
Dos ajustes liberan memoria para sesiones de texto largas: quitar un proyector de visión sin uso y reducir la precisión de la caché. Calcula su efecto frente al modelo cargado y las asignaciones del runtime.
Usa este ejemplo, con todas las asignaciones expresadas en GB decimales. La reserva de 1.0 GB es una suposición de planificación, no un valor predeterminado universal del runtime.
| Asignación | Visión activada / visión desactivada |
|---|---|
| Capacidad física de 16 GiB | 17.180 / 17.180 GB |
| Pesos del modelo | 11.800 / 11.800 GB |
| Cabezal MTP opcional | 0.350 / 0.350 GB |
| Estimación del proyector de visión | 0.930 / 0 GB |
| Otras asignaciones supuestas | 1.000 / 1.000 GB |
| Disponible para la caché creciente | 3.100 / 4.030 GB |
A 65,536 bytes por token, 3.100 GB contienen unos 47,300 tokens. Con la visión desactivada, el almacenamiento ideal de 8 bits usaría 32,768 bytes por token y contendría unos 123,000 tokens.
El almacenamiento q8_0 real incluye escalas de bloque. A 34 bytes por cada 32 valores, este ejemplo necesita unos 34,816 bytes por token y reduce la estimación a unos 115,700. Otras asignaciones reducen más el resultado. Unos 110K son una planificación razonable bajo estas suposiciones, no un ajuste garantizado.
El contexto restante debe cubrir entrada y salida. Con una ventana de 65,536 tokens, un prompt inicial ilustrativo de 30,000 tokens y una reserva de salida de 8,192 dejan 27,344 tokens para archivos, resultados de herramientas y conversación. El presupuesto inicial es un ejemplo. Mide tus herramientas e instrucciones.
Ajustes que merece la pena probar
La documentación del servidor llama.cpp documenta tipos separados de caché de claves y valores, carga automática del proyector y ranuras paralelas. Para una carga de texto, prueba la visión desactivada, q8_0 para ambos tipos de caché y una ranura. Empieza con un contexto moderado.
Registra las asignaciones antes de aumentar el contexto. La cuantización de caché necesita soporte de la arquitectura y el backend elegidos. Prueba la calidad de las respuestas después de cambiar la precisión. Conserva una configuración funcional para comparar.
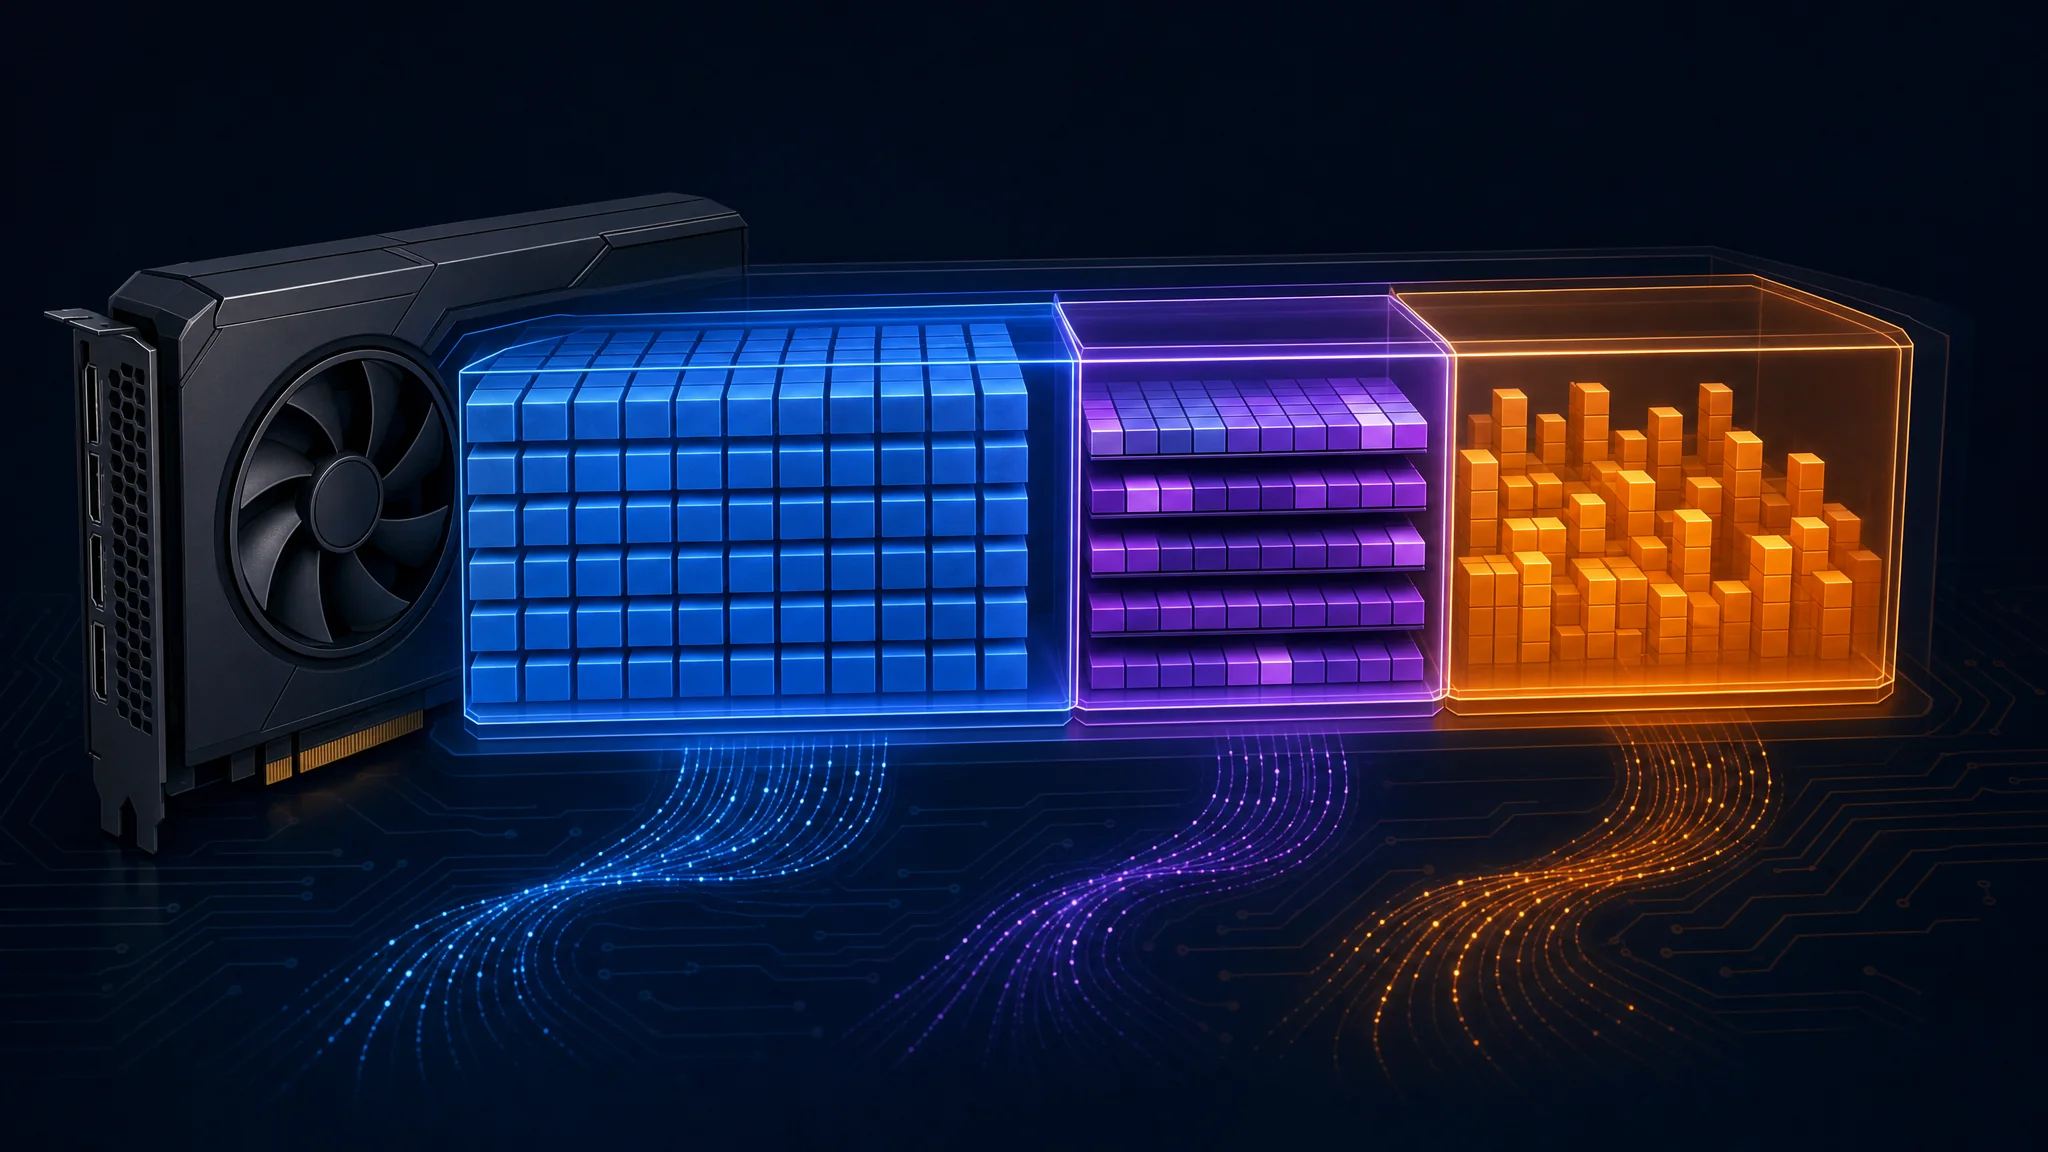
El azul representa los pesos, el morado la caché de contexto y el naranja las asignaciones del runtime. Los tamaños son ilustrativos
Por qué cambian las velocidades
Una etiqueta de 16GB describe la capacidad. El rendimiento también depende del ancho de banda de memoria, los kernels de cálculo, el contexto activo, el offload, el batching y la decodificación especulativa.
| Causa | Qué revisar |
|---|---|
| Offload a CPU o RAM | Ubicación de las capas cargadas y de la caché |
| Contexto largo | Tokens ocupados durante la medición |
| Diferencias de backend | Commit del runtime, controlador y ruta del kernel |
| Decodificación especulativa | Borradores aceptados y asignaciones adicionales |
En un modelo denso que genera un token cada vez, dividir el ancho de banda de memoria por los bytes de pesos residentes produce una estimación aproximada basada solo en ancho de banda. A 448 GB/s y 11.8 GB de pesos, el cociente es de unos 38 tokens por segundo. Las lecturas de caché y el cálculo añaden trabajo. La decodificación especulativa y el batching cambian las suposiciones.
No trates este cociente como un límite superior universal. Una tasa de salida mayor no invalida automáticamente un benchmark. Comprueba si una pasada del modelo objetivo aceptó varios tokens de borrador.
La predicción de varios tokens, o MTP, necesita un modelo y runtime compatibles. Compara ejecuciones activadas y desactivadas con contexto ocupado corto y largo. Los pesos adicionales y el estado de borrador consumen memoria, pero ninguna regla universal exige desactivar MTP después de 32K tokens.
Mide la primera respuesta
Prefill procesa el prompt antes de generar. Decode produce la respuesta. Un decode rápido oculta una primera respuesta lenta cuando la tarea empieza con un prompt grande sin caché.
Divide los tokens de prompt sin caché por el rendimiento de prefill medido para estimar el tiempo de procesamiento. Para un prompt nuevo de 30,000 tokens, dos tasas ilustrativas producen estas esperas:
| Tasa de prompt de ejemplo | Tiempo de procesamiento calculado |
|---|---|
| 750 tokens/s | 40 segundos |
| 150 tokens/s | 200 segundos |
Estos ejemplos describen el tiempo de procesamiento sin cargar el modelo ni contar el overhead de la petición. La longitud del prompt, el tamaño del batch, el formato del modelo y el backend afectan a la tasa medida.
Mide por separado una petición fría y una continuación con un prefijo reutilizable. Reutilizar el prefijo evita procesar parte de la entrada repetida. Registra el tiempo hasta el primer token junto con la tasa de decode y la duración total.
Compara configuraciones GPU completas
Compara precio de compra, memoria útil, ancho de banda y ruta de software en conjunto. Una tarjeta más barata pierde su ventaja si tu carga necesita funciones no compatibles o tarda más que tu objetivo de latencia.
| Tarjeta de escritorio de 16GB | Ancho de banda de memoria |
|---|---|
| RX 9060 XT | 320 GB/s |
| RTX 5060 Ti | 448 GB/s |
| RX 9070 | 640 GB/s |
| RX 9070 XT | 640 GB/s |
Las especificaciones de RX 9070 de AMD y las especificaciones de RX 9070 XT confirman 16GB y hasta 640 GB/s. Comparar 640 con 448 da aproximadamente un 43% más de ancho de banda teórico. Estas especificaciones no implican una mejora de inferencia del 43%.
Elige benchmarks con tu modelo y backend previstos. Para prompts cortos y generación sostenida, da más peso al rendimiento de decode. Para analizar repositorios, prioriza el prefill frío, la velocidad con contexto largo y completar la tarea. Comprueba el software disponible antes de comprar.
Etiquetas de Mac y portátiles
Un Mac Apple silicon de 16GB comparte memoria entre CPU, GPU, sistema operativo y aplicaciones. Una GPU discreta de 16GB tiene memoria de vídeo dedicada junto a la RAM del sistema. Estas capacidades no describen presupuestos de modelo equivalentes.
Apple ofrece un tamaño recomendado del conjunto de trabajo de GPU . Revisa el límite indicado por tu runtime y la presión de memoria del sistema. Deja espacio para macOS y las demás aplicaciones.
En portátiles, comprueba el SKU exacto, la memoria dedicada, el límite de potencia de GPU y la refrigeración. La página de la familia RTX 5060 de NVIDIA lista variantes de memoria de la RTX 5060 Ti de escritorio. El nombre de la familia no demuestra 16GB. Los resultados de escritorio no demuestran el rendimiento de un portátil.
¿Compensa la propiedad?
La propiedad compensa económicamente cuando los cargos de hosting evitados superan los costes de operación y recuperan la compra del hardware. Empieza con un ejemplo solo de salida: tarjeta de $789, 35 tokens de salida/s, 180W durante la generación, electricidad a $0.18/kWh y $2.95 por millón de tokens de salida alojados. Son datos ilustrativos. Sustitúyelos por tu precio, potencia medida, tarifa eléctrica y precios del proveedor.
Hours per million output tokens = 1,000,000 ÷ 35 ÷ 3,600 = 7.94
Electricity per million = 7.94 × 0.180 kW × $0.18/kWh = $0.257
Savings per million = $2.95 - $0.257 = $2.693
Break-even output = $789 ÷ $2.693 = 293 million tokens
Continuous generation time = 293 × 7.94 ÷ 24 = about 97 days
Con ocho horas de generación ininterrumpida al día, el mismo cálculo tarda unos 291 días. Ocho horas con un asistente abierto no equivalen a ocho horas generando tokens.
Con un precio de salida alojado de $0.16 por millón, la electricidad local ya cuesta más que el hosting en este escenario. Bajo estas suposiciones no existe un punto de equilibrio positivo solo para salida.
Usa los precios actuales de modelos de OpenRouter del proveedor elegido, incluidos los cargos de entrada y entrada en caché. Mide la energía del sistema completo, incluido el prefill. Añade actualizaciones, energía en reposo, mantenimiento y valor de reventa previsto. Compara el trabajo aceptado, porque los reintentos y las diferencias de calidad cambian el coste por tarea.
Cuándo añadir memoria
Supera 16GB cuando tu carga medida exceda el contexto disponible con calidad y latencia aceptables. Las sesiones largas diarias de agentes, las peticiones simultáneas y los pesos de mayor precisión hacen útil una capacidad mayor.
Dos tarjetas de 16GB requieren soporte explícito del runtime. No se convierten en una asignación transparente de 32GB. Cada dispositivo necesita buffers y la comunicación usa la interconexión del host.
| Estrategia de división | Principal compromiso |
|---|---|
| División por capas | Distintas capas ocupan distintos dispositivos |
| División por tensor o fila | El trabajo dentro de las capas añade comunicación |
| CPU más GPU | Más capacidad con otro perfil de latencia |
Considera una segunda tarjeta cuando placa base, fuente, refrigeración y backend ya admitan el plan. Compara el coste completo con una sola GPU mayor. La guía de hardware Qwen de 32GB cubre esas alternativas.
Solución de problemas y próximos pasos
Si falla la carga, reduce el contexto e inspecciona las asignaciones. Si baja la velocidad durante una sesión, revisa el contexto ocupado y el offload a CPU. Si la primera respuesta se atasca, mide el prefill frío. Si el uso de herramientas falla tras la compresión, compara la misma tarea con un modelo de mayor precisión.
Guarda una prueba repetible con tus instrucciones, archivos y salidas de herramientas habituales. Registra revisión del modelo, versión del runtime, precisión de caché, contexto ocupado, memoria máxima, latencia del primer token, velocidad de decode y si la tarea pasó. Repite cerca de la sesión más larga prevista.
Usa la guía de modelos locales y contexto para comparar alternativas menores. Elige el modelo más pequeño que cumpla tus requisitos de calidad y reserva memoria suficiente para la tarea completa. En esas condiciones, 16GB son un objetivo útil para una estación de trabajo.
Related Posts