Dentro de nuestra flota híbrida de agentes de IA: Hermes, LiteLLM y Tailscale

Table of Contents
Desplegamos una flota local de GPU con asignación por solicitud y diseñamos su plano de control híbrido. La ruta verificada comienza en LiteLLM, selecciona un grupo de modelos y carga un modelo local en una sola GPU a la vez. La política de niveles de Hermes es una propuesta, y hay un artefacto de configuración de Tailscale Aperture listo para la siguiente prueba de integración. No se ha verificado que ambos formen parte de una única ruta integral.
Las GPU inactivas minan Pearl. Una solicitud de IA pausa la minería solo en la tarjeta arrendada, atiende la solicitud, descarga el modelo y devuelve la tarjeta al minero.
Puntos clave
- T0 a T2 atienden el trabajo costoso o exigente. Estas rutas priorizan modelos de frontera alojados y cadenas de respaldo ordenadas.
- T3 atiende trabajo local sustancial. La flota asigna planificación, programación, revisión y visión a modelos de 4B a 12B.
- T4 atiende trabajo local de gran volumen. Los modelos pequeños enrutan, clasifican, extraen, generan embeddings y completan tareas de código acotadas.
- Cada GPU es un recurso independiente. Una tarjeta atiende IA mientras las demás siguen minando.
- Los modelos locales permanecen descargados mientras están inactivos. Ningún modelo ocupa memoria de GPU entre ventanas de solicitudes.
- Todas las puertas de enlace exponen el mismo catálogo lógico. Los alias compartidos distribuyen el trabajo entre sistemas aptos. Los alias con prefijo de nodo mantienen la ubicación exacta cuando hace falta.
- El intermediario experimental no llegó a producción. Su prueba canaria atendió una solicitud y luego falló una prueba de apagado limpio. LiteLLM siguió en la ruta verificada por solicitud.
- Hermes y Aperture siguen en fase de preparación. Existe un diseño objetivo, pero las pruebas de aceptación de extremo a extremo siguen pendientes.
Requisitos previos: varios hosts Linux con GPU, controladores NVIDIA estables, una red privada de Tailscale, systemd, un minero operativo, almacenamiento para modelos y pruebas de aceptación para cada ruta de modelo.
Tiempo y dificultad: avanzado. Reserva varios días para inventariar, descargar modelos, definir servicios, probar el enrutamiento, simular fallos y comprobar la recuperación de minería en cada tarjeta.
Términos usados a continuación: una tailnet es la red privada formada por identidades y dispositivos de Tailscale. Un alias de modelo es un nombre estable de modelo que se presenta a los clientes. Un grupo de modelos reúne varios despliegues bajo un alias. Un proxy de grupo es el pequeño servicio local que arrienda una GPU, inicia el proceso del modelo y devuelve la tarjeta a la minería.
Objetivo del diseño
El trabajo con agentes llega de muchas formas. La reparación de un repositorio necesita un modelo distinto al de un título, una captura de pantalla, un embedding o una etiqueta de intención. Enviar cada turno al modelo más grande desperdicia dinero y capacidad local. Enviar cada turno al más pequeño genera reintentos y resultados débiles.
Queríamos un catálogo con cinco bandas de carga. La política debía atender modelos alojados y locales mediante formatos de API conocidos. Las GPU locales debían seguir siendo útiles entre solicitudes de IA.
La flota también necesitaba concurrencia. Un host con varias tarjetas debía atender varios trabajos independientes a la vez. Una solicitud en una tarjeta no debía detener la minería en todas las tarjetas del equipo.
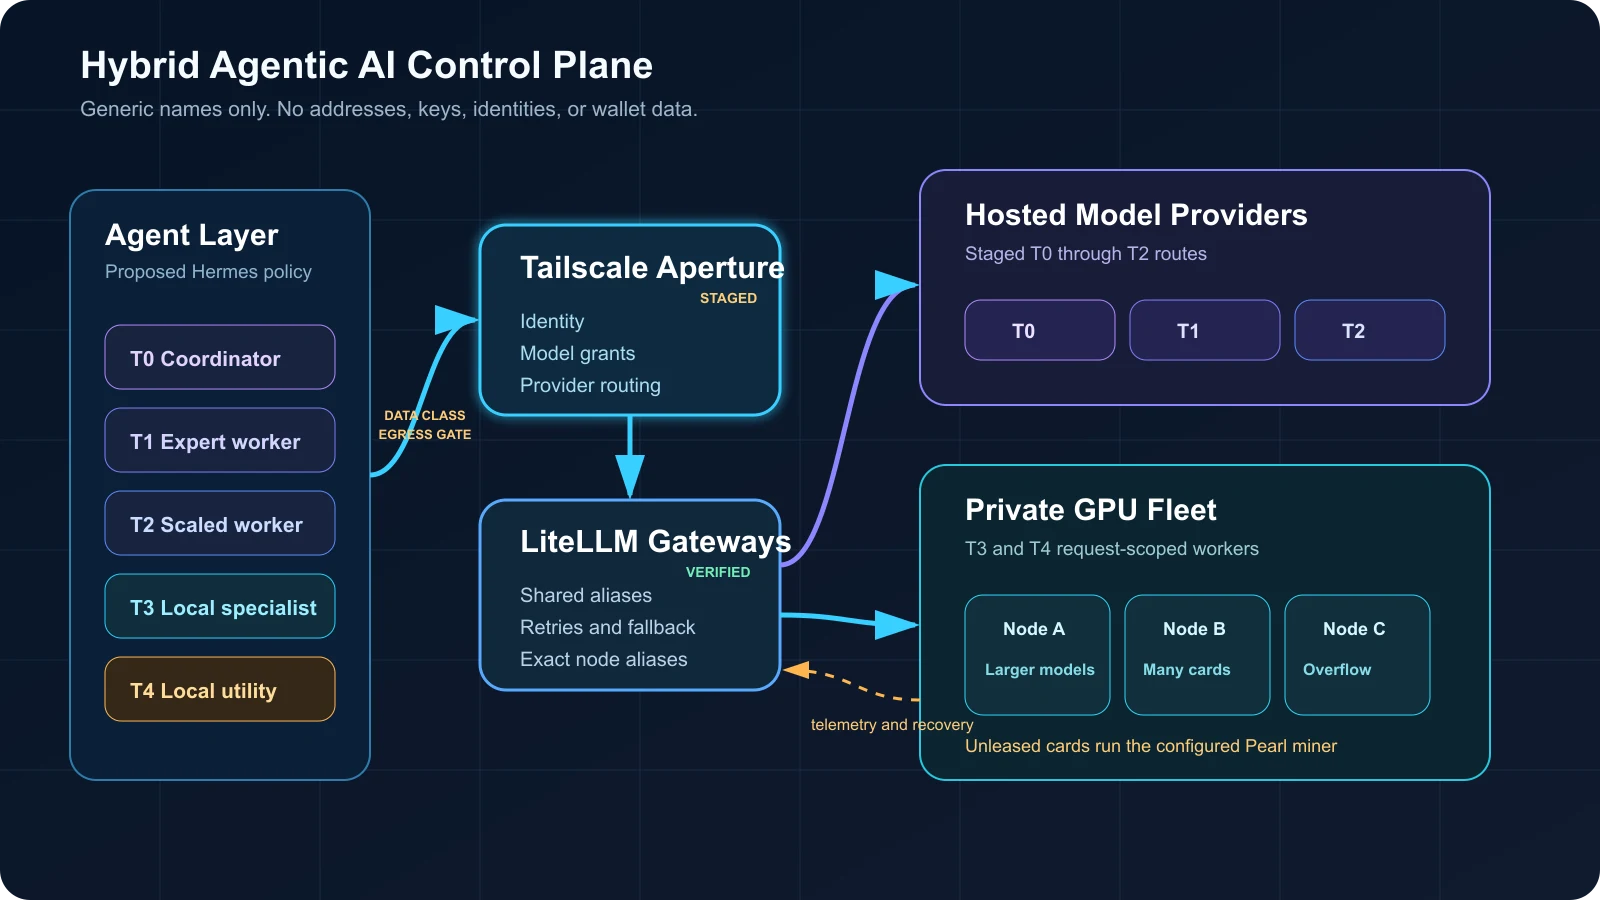
La ruta de control propuesta y preparada se sitúa sobre la ruta verificada de ejecución con LiteLLM y por GPU
El diagrama usa nombres de nodo genéricos. Omite direcciones privadas, identidades de usuario, claves de acceso, datos de monederos y etiquetas de hosts físicos.
Qué significan T0 a T4
Los nombres de nivel son nuestra política de enrutamiento. No son un estándar del sector ni describen solo el tamaño del modelo.
| Nivel | Función principal | Destino habitual | Respuesta ante fallos |
|---|---|---|---|
| T0 | Coordinador predeterminado y decisiones más difíciles | Modelo de razonamiento de frontera alojado | Cadena de respaldo alojada y ordenada |
| T1 | Agentes trabajadores de alto valor | Grupo de modelos alojados de gran capacidad | Reintentar dentro de la cadena asignada |
| T2 | Grupo amplio de agentes trabajadores | Modelos alojados rápidos, con escalamiento | Escalar el trabajo difícil a T1 o T0 |
| T3 | Trabajo local privado sustancial | Modelos locales de chat, código, revisión y visión de 4B a 12B | Reintentar en un nodo local apto y luego fallar de forma cerrada para datos restringidos |
| T4 | Trabajo local acotado y frecuente | Modelos de 0,6B a 3B para enrutamiento, clasificación, código y embeddings | Reintentar en una réplica local o pasar a T3 dentro del mismo límite de datos |
Los niveles describen el trabajo antes que el modelo. Una clasificación breve y sensible a la seguridad encaja en T4. Un plan largo para un repositorio encaja en T3 o superior. Una decisión arquitectónica difícil empieza en un nivel superior aunque la instrucción sea breve.
Esta división también cambia la economía de los agentes. Los trabajadores T4 absorben transformaciones repetidas de bajo riesgo. Los trabajadores T3 mantienen el código y el análisis habituales dentro de la tailnet. T0 a T2 siguen disponibles para tareas difíciles y recuperación ante fallos.
Una barrera de clasificación de datos debe preceder a cualquier respaldo alojado. Los trabajos públicos, internos y restringidos usan cadenas distintas. El trabajo restringido permanece local y falla de forma cerrada. Para reintentar cruzando un límite se necesita entrada saneada y aprobación explícita del usuario o del flujo de trabajo. La redacción elimina credenciales, secretos del repositorio, salida privada de herramientas y contenido sensible recuperado antes de cualquier llamada alojada.
Cómo Hermes gestionará la política de tareas
Hermes es la capa de agentes propuesta. La política objetivo asigna una clase de modelo, ejecuta herramientas, delega trabajo y recorre cadenas de respaldo explícitas. Hermes documenta rutas separadas para el modelo principal, tareas auxiliares, agentes delegados y respaldos específicos de tareas. También permite endpoints personalizados compatibles con OpenAI mediante una URL base. Consulta la guía de configuración de Hermes y la guía de proveedores de respaldo .
Nuestra política asigna los trabajos de Hermes a alias estables en lugar de servidores físicos. Algunos ejemplos:
t3-smart
t3-code
t3-review
t3-vision
t4-code
t4-classify
t4-router
t4-embedding
El alias expresa la intención. Hermes no necesita saber qué GPU está libre, qué nodo tiene una tarjeta más grande o qué réplica no superó la comprobación de estado. Las capas inferiores se encargan de esas decisiones.
Algunos trabajos siguen necesitando una ubicación determinista. Un ID de modelo con prefijo de nodo envía el diagnóstico de un operador o una prueba comparativa a un sistema elegido. Los permisos de Aperture separados deben limitar estos alias a operadores. El tráfico normal de agentes usa alias compartidos por nivel.
El acceso al modelo no protege las herramientas del agente. El despliegue de Hermes necesita listas de herramientas con privilegios mínimos, espacios de trabajo aislados, credenciales acotadas, controles de salida de red y tratamiento de inyección de instrucciones. Los trabajadores delegados no deben heredar más acceso del que necesita su tarea asignada.
Aperture como límite de identidad preparado
Tailscale conecta la puerta de enlace y los hosts de inferencia configurados sin publicar cada servicio en Internet. Aperture está preparado como límite visible al usuario y enrutador de modelos. Esta ruta aún necesita una prueba de aceptación de extremo a extremo. Tailscale documenta el acceso cifrado del cliente por la tailnet y el reenvío del proveedor mediante TLS en Cómo funciona Aperture .
Aperture también separa la conectividad del permiso. Sus permisos deniegan por defecto. Un usuario o dispositivo etiquetado necesita un permiso de modelo coincidente después de llegar a la puerta de enlace. La guía de permisos de Aperture explica el modelo de permisos aditivo y las fuentes de identidad.
La configuración de Aperture preparada debe seguir cuatro reglas antes del despliegue:
- Una identidad con nombre conserva el rol de administrador. El acceso general a modelos no concede administración.
- Los proveedores enumeran IDs de modelo literales. Aperture no deduce los modelos de un servicio ascendente.
- Las URL de proveedores apuntan a direcciones de la tailnet. Los nombres y direcciones de nodos privados no aparecen en el artículo ni en ejemplos de configuración pública.
- Los secretos permanecen en archivos propiedad del servicio. Antes del despliegue, aplica permisos solo para el propietario, cuentas de servicio restringidas, rotación y redacción de registros. La salida de diagnóstico nunca debe imprimir claves de LiteLLM, direcciones de tailnet, tokens de suscripción ni datos de monederos.
Aperture añade la ruta de la solicitud entrante a la URL base de cada proveedor. Su
referencia de configuración
advierte que no se debe colocar un sufijo /v1 duplicado en la raíz del proveedor. Este detalle generó suficiente riesgo de integración para requerir una comprobación explícita.
La visión está preparada para usar el formato OpenAI Chat Completions con contenido de imagen. Los embeddings usan directamente el endpoint privado de LiteLLM porque la matriz actual de proveedores autohospedados de Aperture documenta formatos de chat, mientras que nuestra ruta de embeddings depende de endpoints de LiteLLM y llama.cpp fuera del selector de chat. Consulta la referencia de proveedores y clientes compatibles .
La ruta directa de embeddings necesita su propio límite de autorización. La autenticación de LiteLLM, permisos restrictivos de Tailscale, vinculación del servicio a la interfaz de tailnet y reglas de firewall del host deben limitar el acceso a identidades o etiquetas de servicio aprobadas. Una dirección privada por sí sola no constituye una política de autorización.
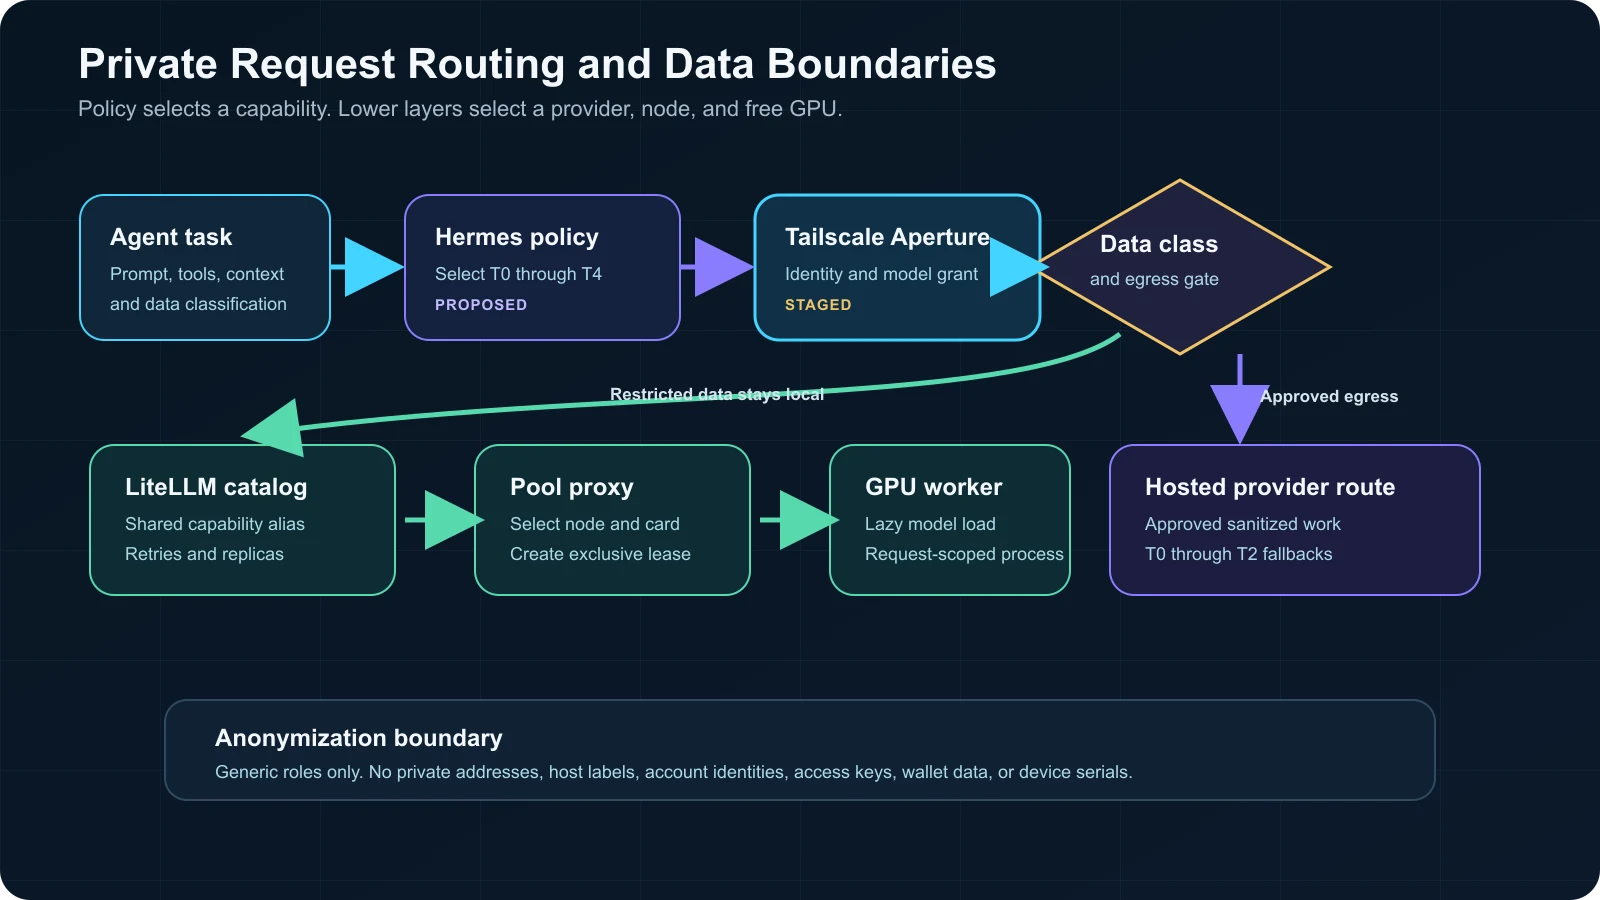
La identidad, los permisos y la clasificación de datos determinan si una solicitud sale de la flota privada
LiteLLM presenta un catálogo
Cada host de inferencia ejecuta una puerta de enlace LiteLLM. Todas las puertas de enlace exponen el mismo catálogo lógico de modelos, incluso si un modelo está en otro nodo. El cliente mantiene una sola forma de API y un conjunto de alias.
LiteLLM agrupa varios despliegues bajo un nombre de modelo. Después, su enrutador elige un despliegue apto y aplica reintentos, tiempos de espera, periodos de enfriamiento o respaldos. La documentación actual de enrutamiento de LiteLLM describe nombres de modelo compartidos, estrategias de enrutamiento y comportamiento de reintentos.
El catálogo tiene dos estilos de dirección:
| Estilo de dirección | Ejemplo | Uso |
|---|---|---|
| Alias compartido | t4-classify | Distribuir el trabajo normal entre nodos aptos |
| Alias de nodo | node-b/qwen-small | Ejecutar diagnósticos o conservar la ubicación |
Los alias compartidos permiten escalar horizontalmente sin cambiar Hermes. Añadir una réplica apta amplía el grupo de modelos. Quitar una réplica con fallos reduce el grupo.
Mantenemos la lógica del ciclo de vida de la GPU por debajo de LiteLLM. La puerta de enlace permanece activa porque su huella de memoria no reserva memoria de GPU. Un proxy de grupo local recibe la solicitud del modelo seleccionado, arrienda una tarjeta, inicia el trabajador y lo detiene tras la respuesta.
Catálogo de modelos locales
La flota prioriza modelos de hasta 12B parámetros. Este límite se ajusta a la memoria disponible en las tarjetas y deja espacio para el contexto y los búferes del entorno de ejecución.
Notación de modelos: B significa miles de millones de parámetros. K significa miles de tokens de contexto configurados. La cuantización almacena los pesos del modelo con menor precisión numérica para reducir el uso de memoria. La caché KV mantiene el estado de atención del contexto activo y crece con la longitud de la instrucción. E4B es la etiqueta de tamaño de Google para la variante menor Gemma 4.
| Ruta de nivel | Clase de modelo | Contexto configurado | Tarea principal | Ubicación |
|---|---|---|---|---|
| T3 inteligente | Qwen3.5 9B, cuantizado | 64K | Planificación local difícil y trabajo general de agentes | Nodos GPU con más memoria |
| T3 código | Granite 4.2 8B, cuantizado | 64K | Trabajo con repositorios, herramientas, terminal y salida estructurada | Nodos GPU con más memoria |
| T3 revisión | Gemma 4 12B, cuantizado | 32K | Revisión independiente y razonamiento alternativo | Nodos GPU con más memoria |
| T3 general y visión | Qwen3.5 4B, cuantizado | 32K | Trabajo general escalable y comprensión de imágenes | Todas las GPU compatibles |
| T3 revisión alternativa | Gemma 4 E4B, cuantizado | 8K | Ruta de revisión diversa | Todas las GPU compatibles |
| T4 código | Granite 4.2 3B, cuantizado | 16K | Ediciones pequeñas, llamadas a herramientas y salida estructurada | Todas las GPU compatibles |
| T4 clasificación | Qwen3.5 2B, cuantizado | 16K | Clasificación, extracción y reescritura | Todas las GPU compatibles |
| T4 enrutador | Qwen3.5 0.8B, cuantización de alta precisión | 16K | Intención, etiquetas, títulos y transformaciones breves | Todas las GPU compatibles |
| T4 embeddings | Qwen3 Embedding 0.6B, cuantizado | 32K | Memoria de agentes, RAG, recuperación de código y agrupación | Todas las GPU compatibles |
Estos valores de contexto son ajustes del despliegue, no los límites anunciados de los modelos. Una ventana anunciada más amplia sigue consumiendo caché KV y memoria del entorno. Elegimos valores menores para mantener un servicio estable en una sola tarjeta.
Qwen describe Qwen3.5 como una familia multimodal y publica variantes densas pequeñas y grandes en la colección Qwen3.5 . IBM publica resultados de programación agéntica y contexto largo para Granite 4.2 8B . Google enumera entrada multimodal, llamada a funciones y una ventana anunciada mayor para Gemma 4 .
La ruta de embeddings usa un modelo separado en lugar de pedir vectores a un modelo de chat. La tarjeta del modelo Qwen3 Embedding 0.6B indica una longitud de secuencia de 32K, recuperación multilingüe, recuperación de código y dimensiones de salida de hasta 1.024.
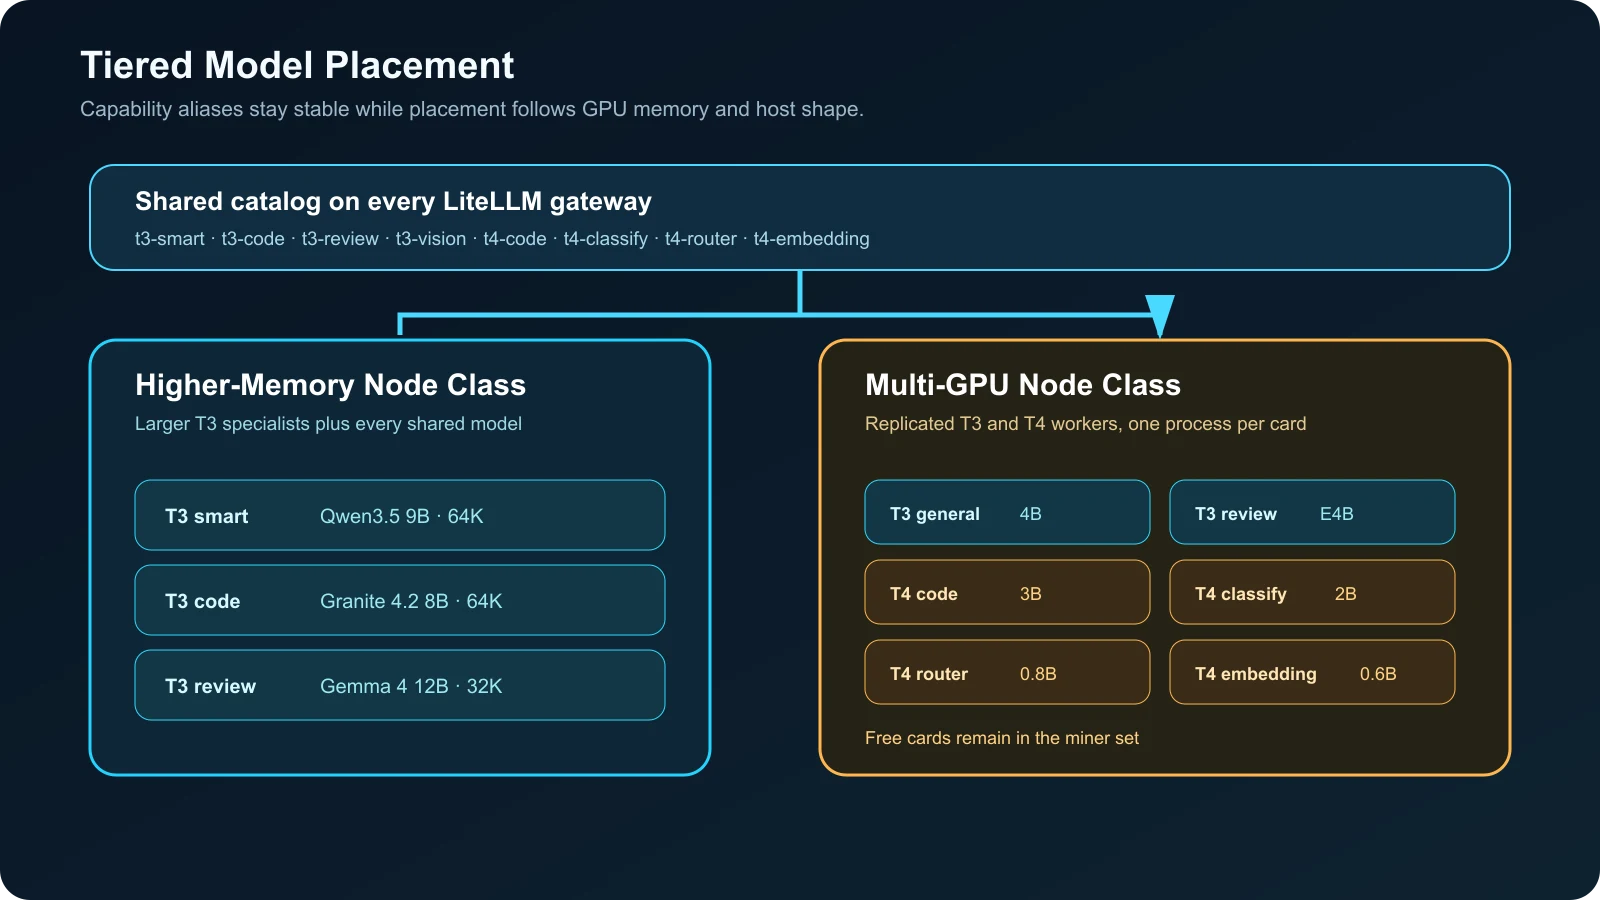
Los especialistas grandes permanecen en tarjetas con más memoria y los especialistas pequeños se replican en toda la flota
Por qué llama.cpp está en producción
llama.cpp se ajusta al modelo de recursos. Un trabajador estático corresponde a una GPU, un archivo de modelo, un contexto configurado y un arrendamiento. El límite del proceso facilita auditar el inicio, la detención, la visibilidad de GPU y los registros.
Su servidor expone chat, respuestas y embeddings compatibles con OpenAI. También admite decodificación paralela y procesamiento continuo por lotes. La documentación actual del servidor etiqueta el soporte multimodal como experimental. Estas funciones aparecen en la documentación del servidor llama.cpp .
Ollama sigue disponible como ruta de compatibilidad en un nodo mayor. Ollama admite cargas simultáneas de modelos cuando cabe la memoria y descarga inmediata mediante keep_alive: 0, según la
FAQ de Ollama
. No elegimos Ollama para la ruta de producción por tarjeta porque los trabajadores estáticos de llama.cpp ofrecían un control más preciso de ubicación y detención.
También evaluamos Strata. Strata está pensado para un gran modelo de mezcla de expertos Qwen distribuido entre la memoria de GPU, la RAM del sistema y el almacenamiento. Sus ajustes publicados empiezan en 32 GB de memoria combinada, mientras que el modo de poca RAM intercambia velocidad por menor capacidad. Consulta el repositorio de Strata . Strata se ajusta a otro objetivo: un modelo híbrido más grande que use una o varias tarjetas. Nuestra flota prioriza muchos trabajadores independientes de menos de 12B.
Carga bajo demanda por GPU
La carga bajo demanda se aplica a cada trabajador de modelo. Entre solicitudes, el sistema mantiene activos solo las puertas de enlace, los proxies de grupo, los vigilantes y el minero.
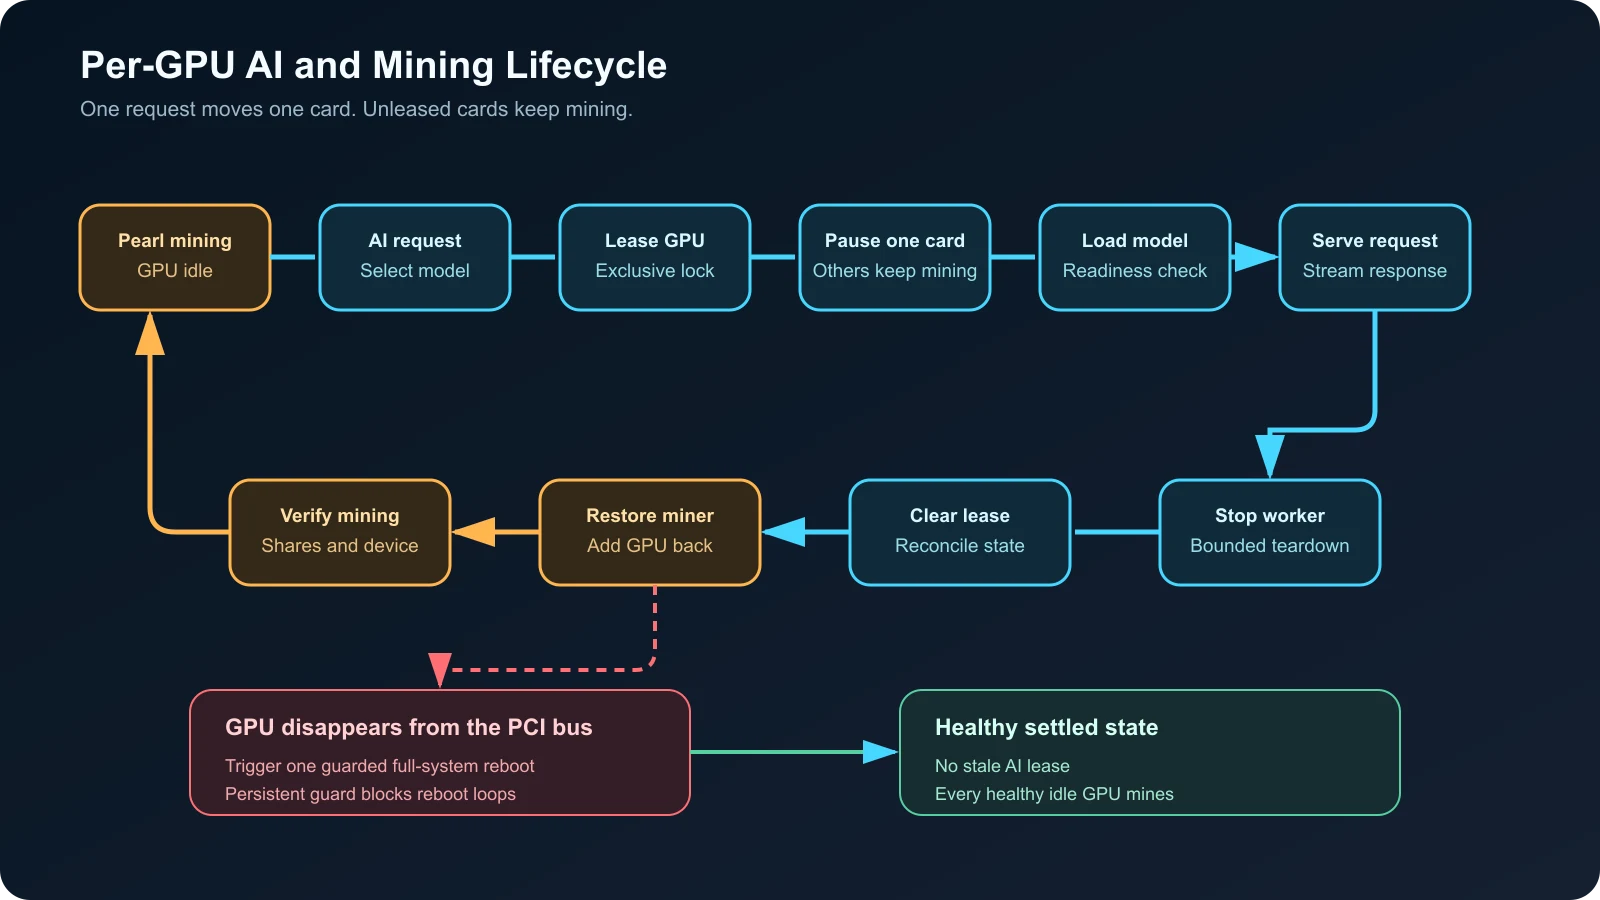
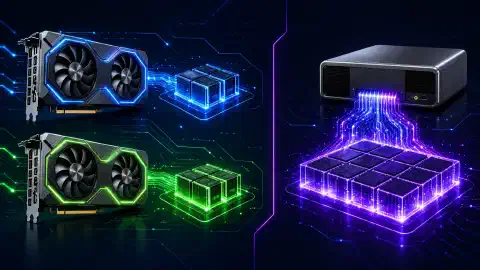
Solo la tarjeta arrendada sale del minero y vuelve después de que termina el proceso del modelo
El ciclo de vida de la solicitud sigue estos pasos:
- LiteLLM selecciona un despliegue. La solicitud llega a un proxy de grupo para la clase de modelo elegida.
- El grupo adquiere un arrendamiento. Un bloqueo impide que dos trabajadores exclusivos ocupen la misma tarjeta.
- El minero se reinicia sin una GPU. Todas las tarjetas no arrendadas siguen en el comando de Pearl.
- llama.cpp se inicia en el dispositivo arrendado. Las comprobaciones de disponibilidad terminan antes de que el proxy reenvíe la solicitud.
- El trabajador responde. Las solicitudes simultáneas inician trabajadores en otras tarjetas libres.
- El trabajador termina. El grupo quita el arrendamiento después de detener el proceso.
- El minero se reinicia con la GPU liberada. Las comprobaciones de estado confirman que la tarjeta volvió a minar.
Esto difiere de cambiar el host entero de una vez. Un chasis con varias tarjetas atiende varios modelos mientras las demás siguen minando. La flota inactiva devuelve cada GPU sana a Pearl.
El libro blanco de Pearl describe su sistema de prueba de computación matricial. Nuestra arquitectura no depende de una previsión de rentabilidad ni de una afirmación sobre el rendimiento económico. La minería es la carga inactiva configurada.
La gestión de fallos importa más que el inicio
El inicio del modelo es solo la mitad del ciclo de vida. Las detenciones forzadas, GPU desaparecidas, solicitudes interrumpidas, arrendamientos obsoletos y reinicios del minero necesitan un tratamiento explícito.
Nuestro vigilante compara el conjunto de GPU configurado con la lista activa de dispositivos NVIDIA. La ausencia confirmada de una GPU provoca un único reinicio completo del sistema, protegido por controles. Un disparador de producción seguro debería exigir varias comprobaciones fallidas, un periodo de enfriamiento, el vaciado de tareas activas, un contador persistente de reinicios y una alerta remota. Una recuperación fallida debe detener la automatización y requerir intervención manual.
El mismo vigilante reconcilia arrendamientos obsoletos. Si ningún trabajador posee un arrendamiento, la reconciliación quita el registro obsoleto y devuelve la GPU al minero. Esta ruta de recuperación fue importante durante la prueba canaria del intermediario.
| Fallo | Respuesta |
|---|---|
| El modelo no queda listo | Detener el trabajador, liberar el arrendamiento, restaurar la minería y devolver un error |
| La solicitud termina de forma inesperada | Limitar el tiempo de limpieza, terminar el árbol de procesos y reconciliar el arrendamiento |
| Desaparece una GPU | Confirmar varias ausencias, vaciar el trabajo activo, iniciar un reinicio protegido, alertar y verificar el conjunto completo de GPU configurado |
| El minero omite una tarjeta inactiva | Reconstruir la lista de dispositivos a partir de los arrendamientos activos y reiniciar el minero |
| Falla un despliegue de LiteLLM | Reintentar otra réplica del mismo grupo y luego aplicar la política de respaldo |
| Un permiso de Aperture bloquea una ruta | Corregir la identidad o el permiso del modelo, nunca eludir la política de la puerta de enlace |
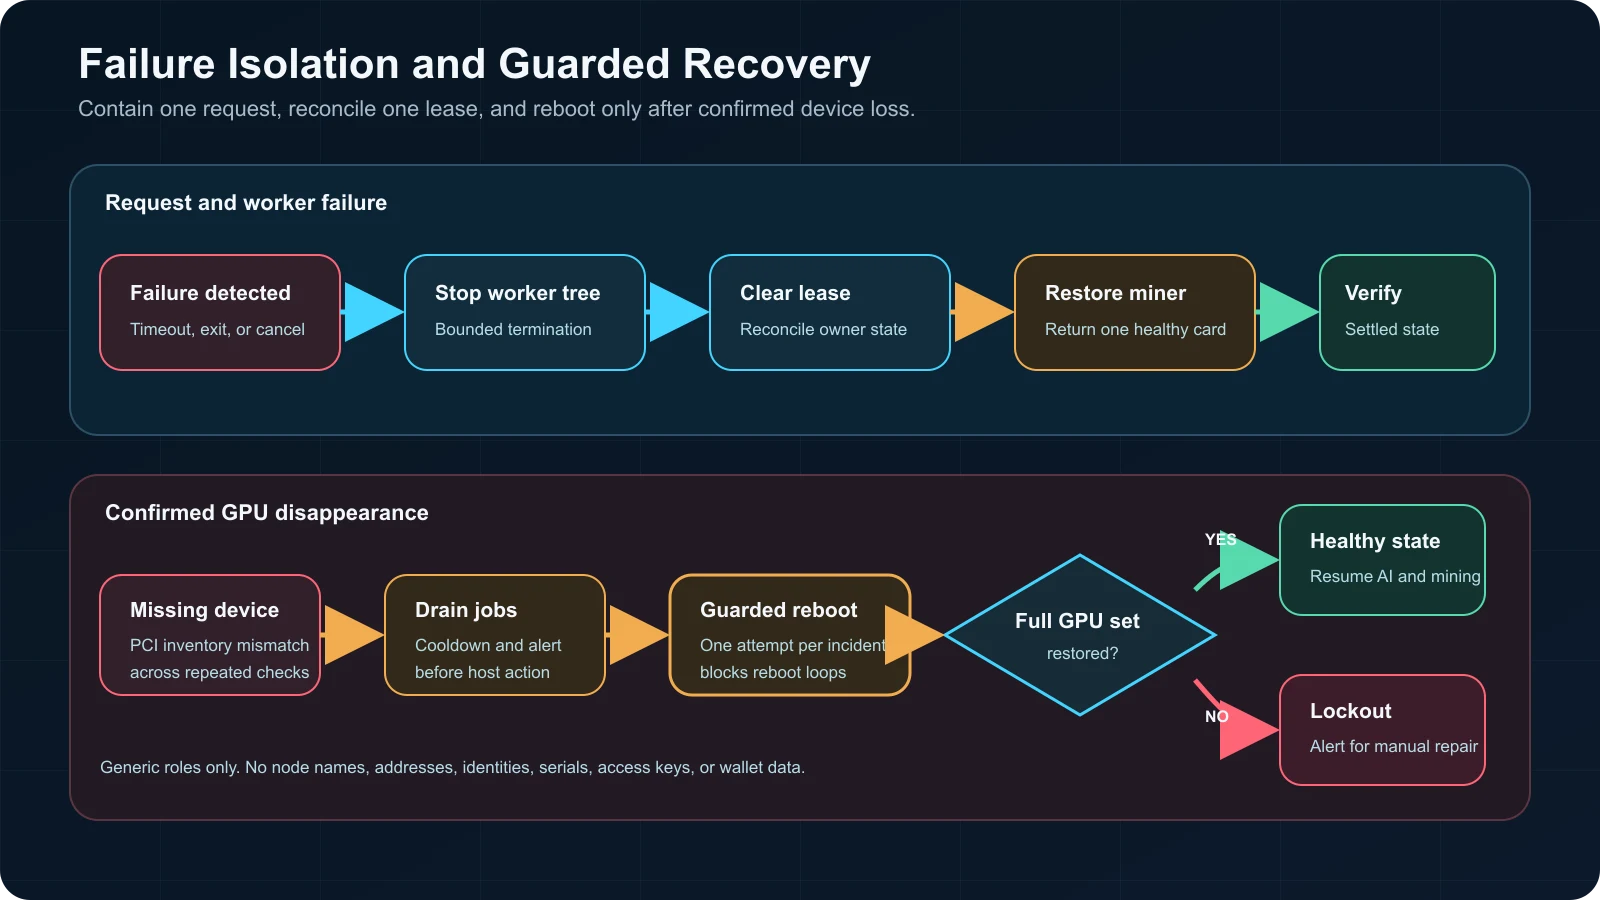
Los fallos rutinarios liberan un arrendamiento; la pérdida confirmada de un dispositivo activa la recuperación protegida del host
Qué ocurrió con el intermediario experimental
El intermediario independiente del backend busca presentar una única interfaz compatible con OpenAI para Ollama, vLLM, llama.cpp y Strata. Incluye gestión del ciclo de vida por modelo, descarga por inactividad y ubicación de GPU.
Probamos la versión 0.6.0 del intermediario en el commit c12b65 el 21 de octubre de 2026. Su conjunto local informó 1.101 pruebas aprobadas y 2 omitidas, con Ruff limpio. Después, la prueba canaria cargó un modelo a demanda y atendió una solicitud de chat correcta. Las demás GPU siguieron minando durante la solicitud.
El apagado reveló un problema crítico del ciclo de vida. Después de cargar un modelo, el intermediario quedó atascado en la ruta de detención hasta que systemd mató el árbol de procesos. La detención forzada dejó un arrendamiento de GPU obsoleto hasta que la reconciliación restauró el minero. También encontramos una brecha entre el ajuste de GPU requerido documentado y su aplicación en el adaptador de producción.
Desactivamos el intermediario en la ruta de producción. LiteLLM ahora enruta por el proxy de grupo bajo demanda. El intermediario seguirá siendo experimental hasta que las pruebas de integración aprueben la detención acotada de procesos secundarios, la terminación de grupos de procesos, las comprobaciones de admisión de GPU requeridas y la limpieza de arrendamientos obsoletos.
Este resultado deja una lección de ingeniería útil. Que un intermediario inicie un modelo una vez demuestra poco. La preparación para producción depende de una detención limpia, recuperación acotada, admisión exclusiva de dispositivos y simulacros de fallos repetibles.
Verificaciones ejecutadas
La prueba de despliegue cubrió más que una respuesta del modelo:
- Cada modelo de chat compartido completó el ciclo de carga, respuesta, detención y recuperación de Pearl en al menos un host apto.
- Visión aceptó imágenes por la ruta de chat.
- Los embeddings devolvieron el tamaño de vector configurado por la ruta privada de LiteLLM.
- Varios modelos se ejecutaron simultáneamente en tarjetas distintas.
- Las tarjetas no arrendadas permanecieron en el minero durante solicitudes de IA simultáneas.
- Los alias compartidos se enrutaron entre nodos aptos.
- Los alias con prefijo de nodo mantuvieron una ubicación determinista.
- Todas las puertas de enlace LiteLLM enumeraron el mismo catálogo lógico.
- Una GPU ausente se recuperó tras un reinicio completo del host. El vigilante ahora tiene un seguro persistente contra bucles.
- Un fallo de apagado del intermediario se recuperó mediante la reconciliación del arrendamiento.
- El estado final estable no mostró arrendamientos de IA y todas las GPU sanas volvieron al conjunto del minero.
No tratamos las comprobaciones de estado ni los listados de modelos como pruebas de carga del modelo. Una prueba de aceptación útil envía una solicitud real, comprueba la respuesta, confirma la GPU seleccionada, observa la detención y verifica la recuperación de minería.
Solución de problemas de la flota
| Síntoma | Primera comprobación |
|---|---|
| El modelo aparece pero fallan las solicitudes | ID del modelo ascendente, formato de API, cabecera de autenticación y URL base del proveedor |
| Aperture devuelve 405 | La raíz del proveedor no tiene un sufijo /v1 duplicado |
| La solicitud llega al nodo equivocado | Alias compartido frente a alias con prefijo de nodo |
| Dos trabajadores intentan usar una tarjeta | Bloqueo del arrendamiento, estado obsoleto y lógica de admisión de GPU |
| La minería se detiene en todas las tarjetas | El código de reinicio del minero construye la lista de dispositivos a partir de los arrendamientos activos |
| Una GPU no vuelve a minar | Árbol de procesos del trabajador, reconciliación del arrendamiento y lista de dispositivos del minero |
| La carga inicial es lenta | Tamaño del modelo, velocidad de almacenamiento, ancho de enlace PCIe y carga de CPU del host |
| Fallan las instrucciones largas | Contexto configurado, margen de caché KV y reserva de salida |
| Falta la ruta de embeddings en Aperture | Usa la ruta autenticada de LiteLLM, limitada por identidad de Tailscale y política del firewall del host |
| Se bloquea el apagado del intermediario | Desactiva la ruta del intermediario y devuelve el tráfico al proxy de grupo verificado |
Reglas de diseño que conviene conservar
- Enruta según el propósito del trabajo. El tamaño del modelo por sí solo no define un nivel.
- Mantén la política por encima de la ubicación. Hermes elige un alias de capacidad. LiteLLM selecciona un despliegue. El grupo elige una GPU.
- Trata cada GPU como un arrendamiento independiente. Cambiar el host completo desperdicia tarjetas disponibles.
- Descarga cada modelo inactivo. Las puertas de enlace activas no requieren trabajadores GPU activos.
- Conserva una ruta restringida de ubicación exacta. Los alias de nodo solo para operadores hacen reproducibles los diagnósticos.
- Prueba primero la detención. La recuperación del minero y la limpieza de arrendamientos pertenecen a las pruebas de aceptación.
- Separa chat, visión y embeddings. Una puerta de enlace no implica una única ruta de protocolo.
- Mantén los detalles privados fuera de los diagramas. Publica funciones y flujos, no direcciones, claves, identidades ni datos de monederos.
- Protege la lógica de reinicio. Exige ausencias repetidas, enfriamiento, contador persistente, alerta e intervención manual tras una recuperación fallida.
- Mantén una vía experimental separada. Un intermediario fallido no debe derribar la ruta verificada.
Próximos pasos
La siguiente fase evalúa las cargas. Cada nivel necesita un conjunto fijo de tareas, criterios de aceptación, registros de latencia, ocupación de GPU, tiempo de interrupción de minería y tasas de escalamiento. Esas mediciones mostrarán qué trabajos T2 pertenecen a T3 y cuáles de T3 encajan en T4.
También planeamos ejecutar la primera prueba de aceptación de Hermes a través de Aperture y LiteLLM, y volver a probar el intermediario después de corregir las rutas de apagado y admisión de GPU. La generación de imágenes necesita su propio adaptador OpenAI compatible y bajo demanda antes de incorporarse al mismo catálogo de enrutamiento.
Para dimensionar modelos, lee la guía de modelos de IA local y contexto de GPU . Para los límites de privacidad, lee Privacidad y seguridad de la IA local . Para configurar el minero y conocer sus riesgos, consulta la guía de minería Pearl en vez de tratar la minería inactiva como una ganancia garantizada.

Related Posts