

En 2026, los contenedores dejaron de ser una frontera de seguridad

Table of Contents
Los contenedores comparten un único kernel. En 2026, cuatro familias de vulnerabilidades distintas demostraron que basta un solo fallo del kernel para salir de un contenedor y llegar al host. Copy Fail, Dirty Frag, Fragnesia y CVE-2026-80521 conceden privilegios root a un usuario local sin privilegios. Todas cruzan el límite del contenedor.
Lo preocupante no son los fallos en sí, sino lo barato que resulta encontrarlos con IA y cómo un parche creó otro fallo.
Este artículo explica cómo los contenedores aíslan las cargas de trabajo, por qué ese aislamiento ahora depende de una base cada vez más estrecha, qué hace cada vulnerabilidad de 2026 y en qué tecnología de aislamiento confiar en su lugar.
Lo que aprenderás: registra quién proporciona el código de cada carga, identifica las funciones del kernel que necesita y elige entre contenedores reforzados y un límite de microVM. Trata los casos de 2026 como pruebas de investigación fechadas. Comprueba los avisos actuales de los proveedores antes de modificar un kernel de producción.
Respuesta breve
| Pregunta | Respuesta breve |
|---|---|
| ¿Los contenedores aíslan? | Sí, los procesos y el sistema de archivos. Todos comparten un kernel, así que los fallos del kernel representan un riesgo compartido |
| ¿Por qué ahora? | La búsqueda de fallos asistida por IA redujo el costo de encontrar errores del kernel. Hasta septiembre de 2026 se habían publicado casi 6.000 CVE del kernel |
| ¿Qué rompe el límite? | Cualquier escalada local de privilegios en el kernel. No hace falta una mala configuración del contenedor para escapar |
| ¿Basta con aplicar parches? | Es necesario, pero el ritmo ya no alcanza. Un parche de 2026 introdujo un nuevo fallo explotable |
| ¿Qué funciona mejor? | MicroVM como Firecracker o Kata Containers, que proporcionan un kernel propio a cada carga de trabajo |
| ¿La alternativa es perfecta? | No. El hipervisor también es código. Su superficie de ataque es mucho menor, y esa diferencia es lo importante |
Cómo aíslan los contenedores
Para entender el límite, primero debes entender qué no es un contenedor.
Un contenedor no es una máquina virtual. No tiene un segundo kernel, hardware emulado ni un hipervisor entre el proceso y el hardware. Al ejecutar una imagen de contenedor, ejecutas un proceso en el kernel existente con una vista modificada del sistema.
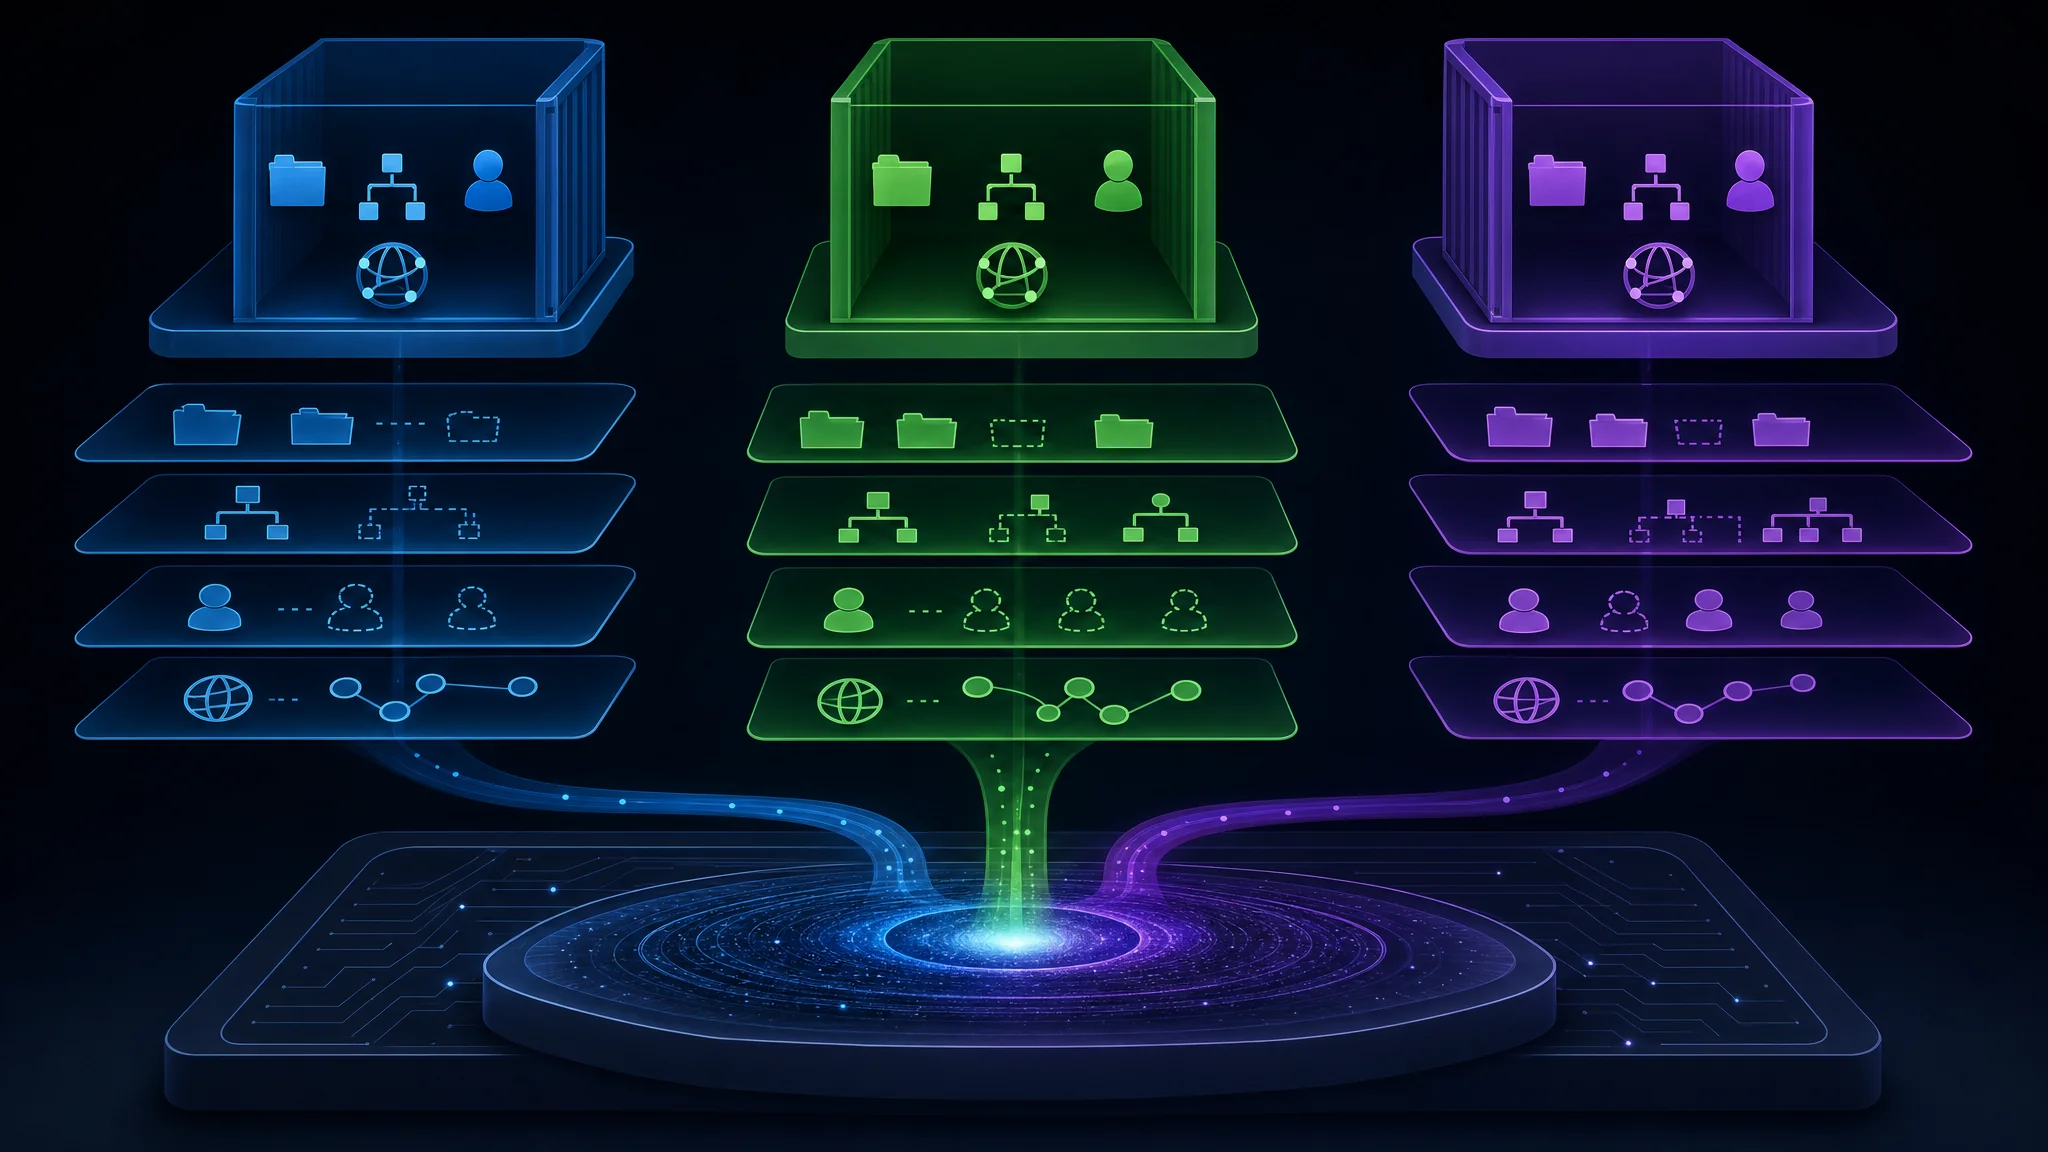
El mecanismo es la llamada de sistema clone. fork copia el espacio de direcciones de un proceso. clone crea un proceso hijo y permite controlar con precisión qué partes del contexto de ejecución se comparten y cuáles se sustituyen. Docker pasa a clone un conjunto de espacios de nombres:
| Espacio de nombres | Qué simula |
|---|---|
| Mount | Una raíz privada del sistema de archivos para que el contenedor vea su propio árbol en lugar del tuyo |
| PID | Numeración propia de procesos, de modo que PID 1 sea el primer proceso del contenedor y no systemd |
| User | Un mapeo de identidad donde “root” dentro del contenedor corresponde a un usuario del host sin privilegios |
| Network | Interfaces, tablas de enrutamiento y puertos privados |
| IPC | Memoria compartida y colas de mensajes aisladas |
| UTS | Nombre de host y dominio propios |
| Cgroup | Una vista privada de los límites de recursos |
Añade un sistema de archivos union sobre una imagen y el resultado parece un equipo independiente. id muestra uid=0(root) en el contenedor. El sistema de archivos parece una instalación mínima de Ubuntu. La lista de procesos solo muestra los propios.
A nivel de llamadas de sistema, esto no es un límite de seguridad. Cuando un proceso del contenedor abre un archivo, asigna memoria o utiliza un socket de red, el mismo kernel gestiona la solicitud para todos los contenedores del host. Los espacios de nombres cambian lo que ve el proceso, no lo que hará el kernel por él.
El kernel es el límite real entre el contenedor y el host. El resto es presentación.
El límite es código, y el código tiene fallos
Toda acción del contenedor pasa por la interfaz de llamadas de sistema. Abrir un archivo, leer memoria, escribir en un socket, cambiar un UID: el kernel media en todo porque no quiere que los procesos toquen directamente la CPU, el sistema de archivos o la red.
Esa mediación constituye el modelo de seguridad y está implementada en código. En concreto, son aproximadamente 30 millones de líneas.
Una escalada local de privilegios (LPE) ocurre cuando un proceso explota un fallo del código mediador para obtener privilegios que nunca recibió. Las LPE no son nuevas. Existen desde los primeros mecanismos de mediación del kernel, y el sector ha convivido con un goteo constante durante décadas.
Dirty Pipe, en 2022, es el ejemplo de referencia que conoce la mayoría. Aprovechó un fallo en la gestión de búferes pipe para sobrescribir archivos de solo lectura. Fue noticia porque fallos de esa gravedad aparecían aproximadamente cada uno o dos años. Se aplicaba el parche y se seguía adelante, suponiendo que no había un gran defecto sin descubrir en el código que leía un millón de personas.
Esa suposición ya no se sostiene.
Qué cambió en 2026
El cambio no está en la habilidad del atacante. Está en que encontrar fallos de corrupción de memoria del kernel pasó de ser una carrera de investigación a una tarea de ingeniería.
Tres datos de este año concretan el cambio:
| Hallazgo | Quién lo encontró | Cómo |
|---|---|---|
| Copy Fail (CVE-2026-31431) | Taeyang Lee, Theori | Con ayuda de Xint Code, una herramienta de análisis estático con IA. Aproximadamente una hora de escaneo del subsistema criptográfico de Linux |
| CVE-2026-80521 | Zhenpeng (Leo) Lin, DepthFirst | Encontrado con dfs-large1, un modelo interno de IA entrenado para detectar vulnerabilidades |
| CVE-2026-80521, hallazgo independiente | Kyle, OpenAI | El mismo fallo, encontrado por separado y reportado el mismo día |
Vuelve a leer la tercera fila. Dos organizaciones que usaron herramientas de IA distintas encontraron el mismo use-after-free en AF_UNIX y lo reportaron a [email protected] el mismo día. No es una coincidencia de talento. Es un proceso repetible que produjo dos veces la misma respuesta.
DepthFirst indica la escala directamente: hasta septiembre de 2026 se habían publicado casi 6.000 CVE del kernel. El número crece con la disponibilidad de asistencia de IA, no con la cantidad de desarrolladores del kernel.
Cuando una hora de escaneo con IA descubre un fallo de hace una década en el subsistema criptográfico, la economía de la explotación del kernel se invierte.
Cuatro escapes en un año
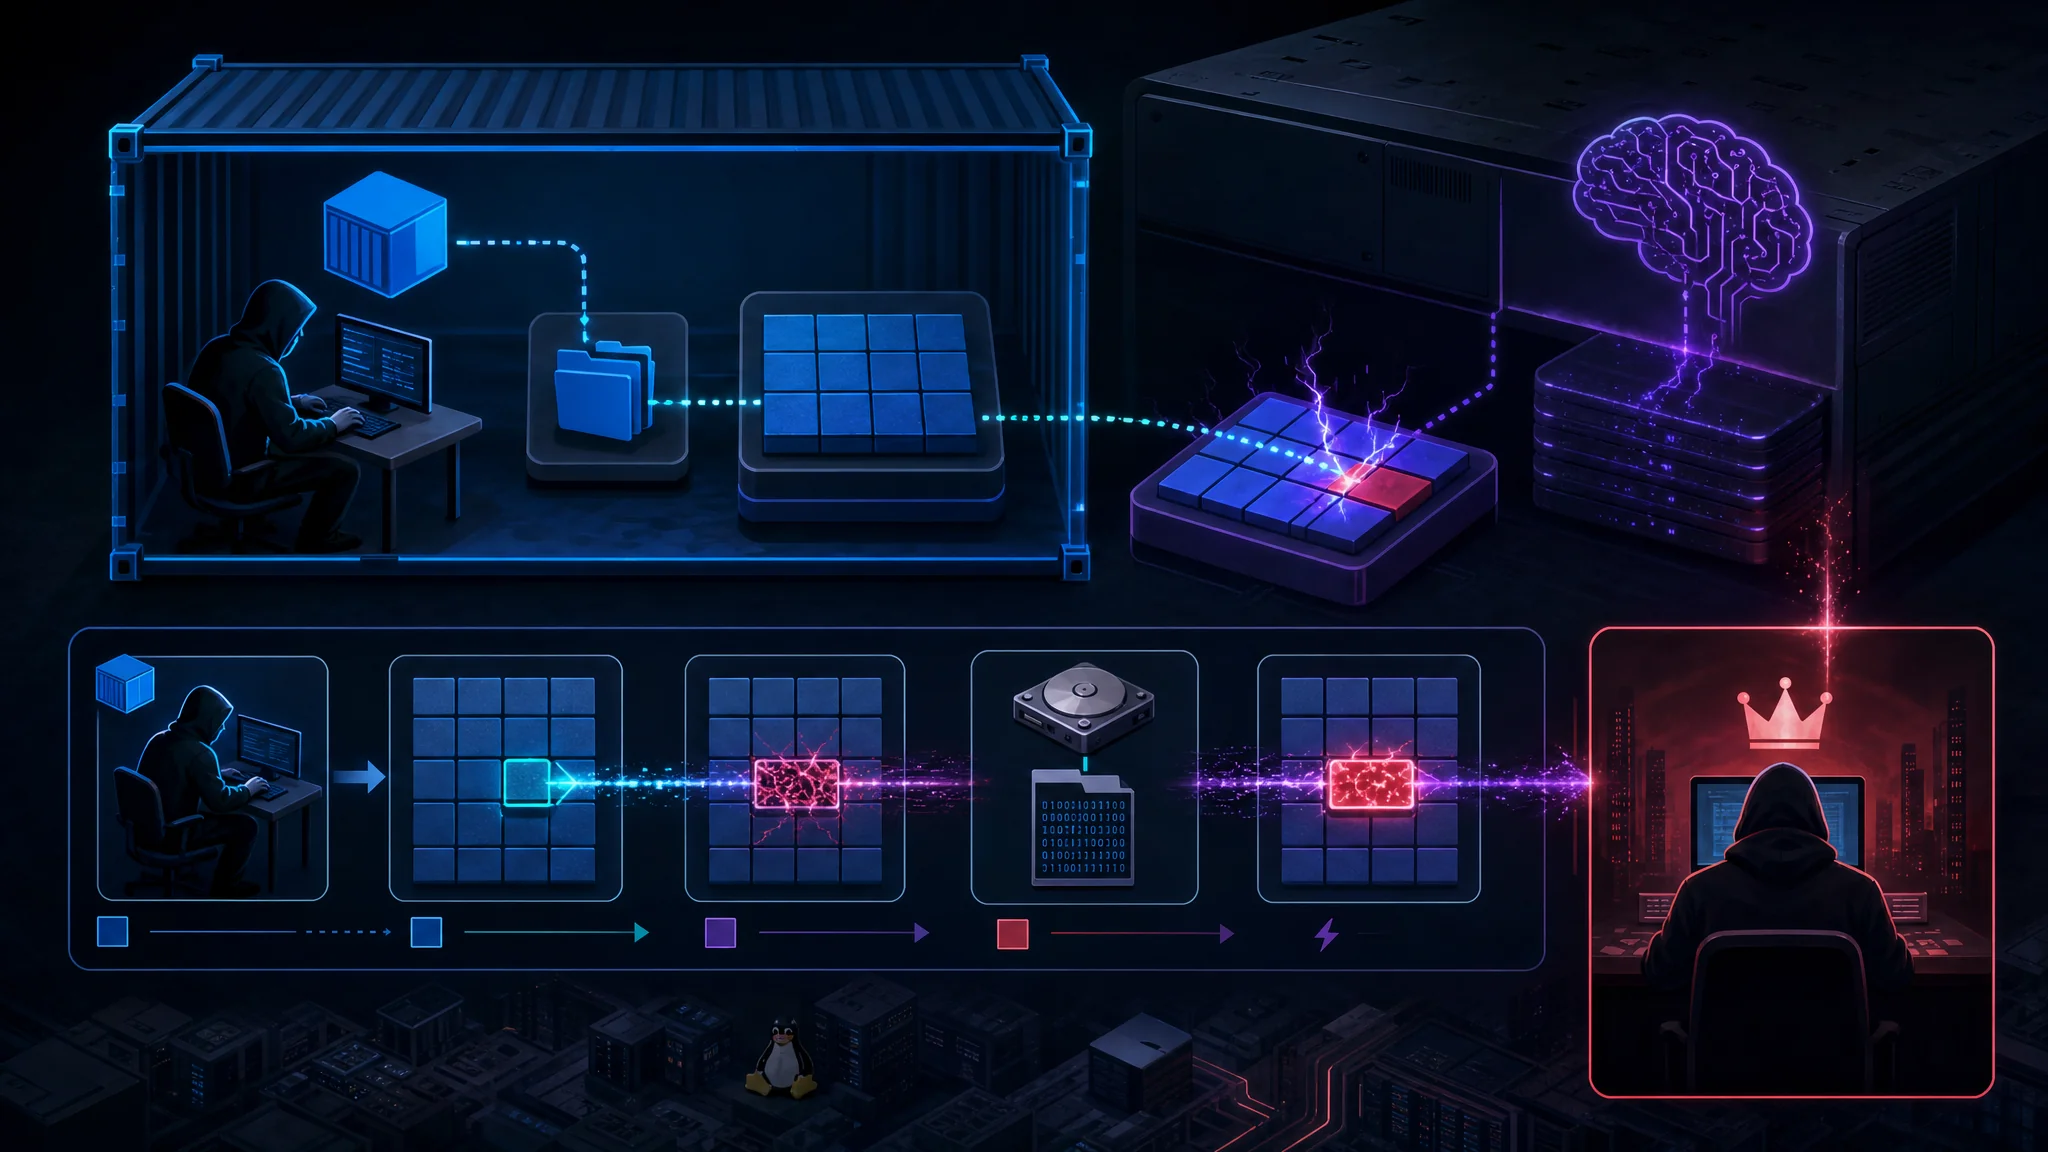
Cada vulnerabilidad concede root a una cuenta local sin privilegios. Ninguna exige una mala configuración del contenedor, una opción privilegiada ni un punto de apoyo en la red.
| Vulnerabilidad | CVE | Subsistema | Primitiva | Encontrada por |
|---|---|---|---|---|
| Copy Fail | CVE-2026-31431 | algif_aead / AF_ALG | Escritura de 4 bytes en la caché de páginas de cualquier archivo legible | Theori, con ayuda de IA |
| Dirty Frag | CVE-2026-43284 + CVE-2026-43500 | XFRM ESP, RxRPC | Escritura de 4 bytes en la caché de páginas mediante dos variantes encadenadas | Hyunwoo Kim |
| Fragnesia | CVE-2026-46300 | XFRM ESP-in-TCP | Escrituras de un solo byte en la caché de páginas | Hyunwoo Kim |
| AF_UNIX UAF | CVE-2026-80521 | Sockets AF_UNIX | Use-after-free en la recolección de basura de unix_vertex | DepthFirst, con ayuda de IA |
Las cuatro comparten un patrón de diseño importante: atacan la caché de páginas, no el disco.
Copy Fail: un fallo lógico sin carrera
Copy Fail es la más simple de las cuatro y la más alarmante.
Casi todas las LPE de Linux necesitan una ventana temporal o un desplazamiento de memoria específico del kernel. Copy Fail no necesita ninguno. Es un fallo lógico directo en algif_aead, el módulo que proporciona al espacio de usuario acceso al cifrado autenticado a través de AF_ALG.
La cadena usa splice() para insertar una página de la caché de páginas en la operación y luego abusa de la ruta AEAD in situ para escribir cuatro bytes controlados en ella. La página corrupta nunca se marca como dirty, así que no se vuelve a escribir en disco. El archivo del disco queda intacto, por lo que pasan las comprobaciones de suma e integridad aunque la copia en memoria tenga la modificación.
Un script Python de 732 bytes obtiene root en todas las distribuciones Linux publicadas desde 2017. El fallo se introdujo con una optimización de 2017 en algif_aead, y el parche de 2026 simplemente revierte esa optimización. Commit mainline a664bf3d603d.
El fallo estuvo casi una década en todas las distribuciones principales, y una herramienta de IA lo encontró en aproximadamente una hora.
Dirty Frag: dos variantes que se complementan
El nombre Dirty Frag describe bien su linaje: Dirty Pipe sobrescribe struct pipe_buffer. Dirty Frag sobrescribe el campo frag de struct sk_buff.
Son dos vulnerabilidades encadenadas, y el encadenamiento es la parte ingeniosa:
- CVE-2026-43284 aprovecha que
esp_input()omite la ruta copy-on-write antes de descifrar in situ un fragmento insertado con splice. Requiere permiso para crear un user namespace, algo que algunas distribuciones restringen. - CVE-2026-43500 aprovecha que
rxkad_verify_packet_1()descifra el fragmento in situ. No necesita privilegios de namespace, pero el módulorxrpcfalta en la mayoría de las distribuciones. Ubuntu lo carga de forma predeterminada.
Cada variante por separado tiene un punto ciego. Juntas se complementan. Si se permiten user namespaces, la ruta ESP se ejecuta primero. Si se bloquean, pero rxrpc está presente, se usa la ruta RxRPC. Así, un único binario de exploit funciona en distintas distribuciones. La variante RxRPC obtiene root vaciando un campo de /etc/passwd y dejando que PAM acepte una contraseña vacía con nullok.
El hallazgo más importante para los defensores: Dirty Frag se activa tanto si algif_aead está disponible como si no. La mitigación de Copy Fail que se difundió ampliamente, basada en bloquear el módulo, no protege en absoluto contra Dirty Frag.
Fragnesia: el parche que creó un fallo
Fragnesia es de la misma clase que Dirty Frag, pero apunta a la ruta ESP-in-TCP de XFRM. Es el caso más instructivo del conjunto.
La vulnerabilidad aprovecha la gestión incorrecta de fragmentos de página compartidos durante la coalescencia de skb. El atacante inserta páginas respaldadas por archivos en la cola de recepción TCP antes de que el socket cambie al modo de protocolo de capa superior espintcp. Al activarse el procesamiento ESP, el kernel descifra los datos en cola in situ, y la manipulación del flujo de claves AES-GCM corrompe la caché de páginas subyacente. El atacante obtiene escrituras repetidas de un byte en páginas de archivos en caché.
El exploit obtiene root sobrescribiendo los primeros bytes de /usr/bin/su con una pequeña carga ELF. El cambio solo existe en memoria y nunca toca el binario en disco.
Los user y network namespaces sin privilegios proporcionan CAP_NET_ADMIN dentro de un namespace aislado. Después NETLINK_XFRM instala una asociación de seguridad preparada.
Conviene detenerse en esta frase: Fragnesia surgió como efecto secundario involuntario de uno de los parches de las vulnerabilidades Dirty Frag originales. El parche de Dirty Frag creó un nuevo fallo independiente que también permite obtener root.
CVE-2026-80521: el escape de contenedor que ganó kernelCTF
La carrera de AF_UNIX acaba con cualquier argumento de que esto sea teórico.
La vulnerabilidad es un use-after-free en el heap del mecanismo de recolección de basura de los mensajes SCM_RIGHTS, que los procesos usan para pasarse descriptores de archivo. Una carrera al recolectar una referencia circular de socket libera un struct unix_vertex mientras el anillo SCC de un socket superviviente todavía guarda un puntero. La siguiente recolección recorre el anillo obsoleto y desreferencia la memoria liberada.
Su importancia va más allá de Linux porque AF_UNIX sustenta la IPC local. Las bases de datos locales, systemd y el propio Docker dependen de él. DepthFirst afirma que la vulnerabilidad afecta a la mayoría de los sandboxes de sistema operativo basados en el kernel, incluidos nsjail, Firejail y Bubblewrap, además de los runtimes de contenedores modernos.
DepthFirst ganó un puesto de Google kernelCTF con este fallo el 24 de julio de 2026, recibió confirmación en el puesto lts-6.12.95 el 5 de agosto, lo reportó a [email protected] ese mismo día y supo que Kyle, de OpenAI, había reportado el mismo fallo. El parche upstream llegó el 6 de agosto. La investigación se publicó el 22 de septiembre.
Publicaron un exploit funcional para Ubuntu 26.04 y un segundo exploit para CVE-2026-52910 que escapa de Ubuntu 24.04.
Por qué siguen fallando las recomendaciones de mitigación
Este año los defensores recibieron tres rondas de soluciones alternativas y todas eran parcialmente incorrectas.
| Mitigación | Qué detiene | Qué deja fuera |
|---|---|---|
Incluir algif_aead en la lista negra | Copy Fail | Nada de Dirty Frag, que ignora por completo el módulo |
Incluir esp4, esp6, rxrpc en la lista negra | Dirty Frag, Fragnesia | Los equipos que necesitan IPsec. También deja fuera subsistemas nuevos |
| Restringir user namespaces sin privilegios | Las variantes ESP | La variante RxRPC no necesita namespace. La política de AppArmor solo es una mitigación parcial |
| Parchear el kernel | El fallo parcheado | El siguiente fallo y cualquier error que introduzca un parche |
Destacan dos patrones.
Primero, las soluciones alternativas entran en conflicto. Copy Fail se mitiga desactivando algif_aead. Dirty Frag se activa haya o no haya ese módulo. Fragnesia requiere desactivar esp4 y esp6, lo que supone un problema para quien usa IPsec. No existe una sola lista negra de módulos que cubra toda la familia.
Segundo, y peor, parchear no es una victoria limpia. Fragnesia fue introducida por el parche de Dirty Frag. Todo parche puede crear nuevos errores lógicos y, en este subsistema, un error lógico se convierte en un exploit root.
La conclusión incómoda: todas estas vulnerabilidades están en la caché de páginas, son accesibles desde código sin privilegios y las encontraron herramientas que mejoran cada trimestre. Ninguna lista de bloqueo se mantiene completa.
Respuesta honesta al contraargumento
Hay una objeción razonable que merece una respuesta directa: los hipervisores también tienen fallos.
La superficie de ataque de KVM es real. Google ejecuta kvmCTF específicamente para encontrar esos fallos y los recompensa generosamente:
| Nivel | Recompensa |
|---|---|
| Escape completo de VM | $250,000 |
| Escritura arbitraria en memoria | $100,000 |
| Lectura arbitraria de memoria | $50,000 |
| Escritura relativa de memoria | $50,000 |
| Denegación de servicio | $20,000 |
| Lectura relativa de memoria | $10,000 |
Las recompensas no se acumulan. El objetivo es un kernel Linux LTS con KVM, y el guest es Debian 12.5. La meta es un ataque del guest al host.
Hyunwoo Kim, el mismo investigador que encontró Dirty Frag, también cobra recompensas de KVM y ganó los $250,000 completos por un escape de VM. La conclusión honesta es que ambas capas tienen fallos y, a veces, los encuentra la misma persona.
Pero comparemos la escala:
| Kernel Linux | Hipervisor KVM | |
|---|---|---|
| CVE en 2026 | Casi 6.000 | Unas pocas; cada investigador encuentra varias al año |
| Accesible desde | Cualquier proceso sin privilegios, por la interfaz syscall | Solo código que ya se ejecuta dentro de un guest |
| Superficie de ataque | Todo: redes, sistemas de archivos, criptografía, IPC y drivers | El dispositivo virtual y la interfaz hypercall |
| Clase de fallo | Cualquier defecto de seguridad de memoria o lógica en 30 millones de líneas | Limitada al límite de virtualización |
La diferencia es de varios órdenes de magnitud, no del doble. Esa brecha explica por qué las microVM cambian el cálculo del riesgo.
Qué proporciona un límite real
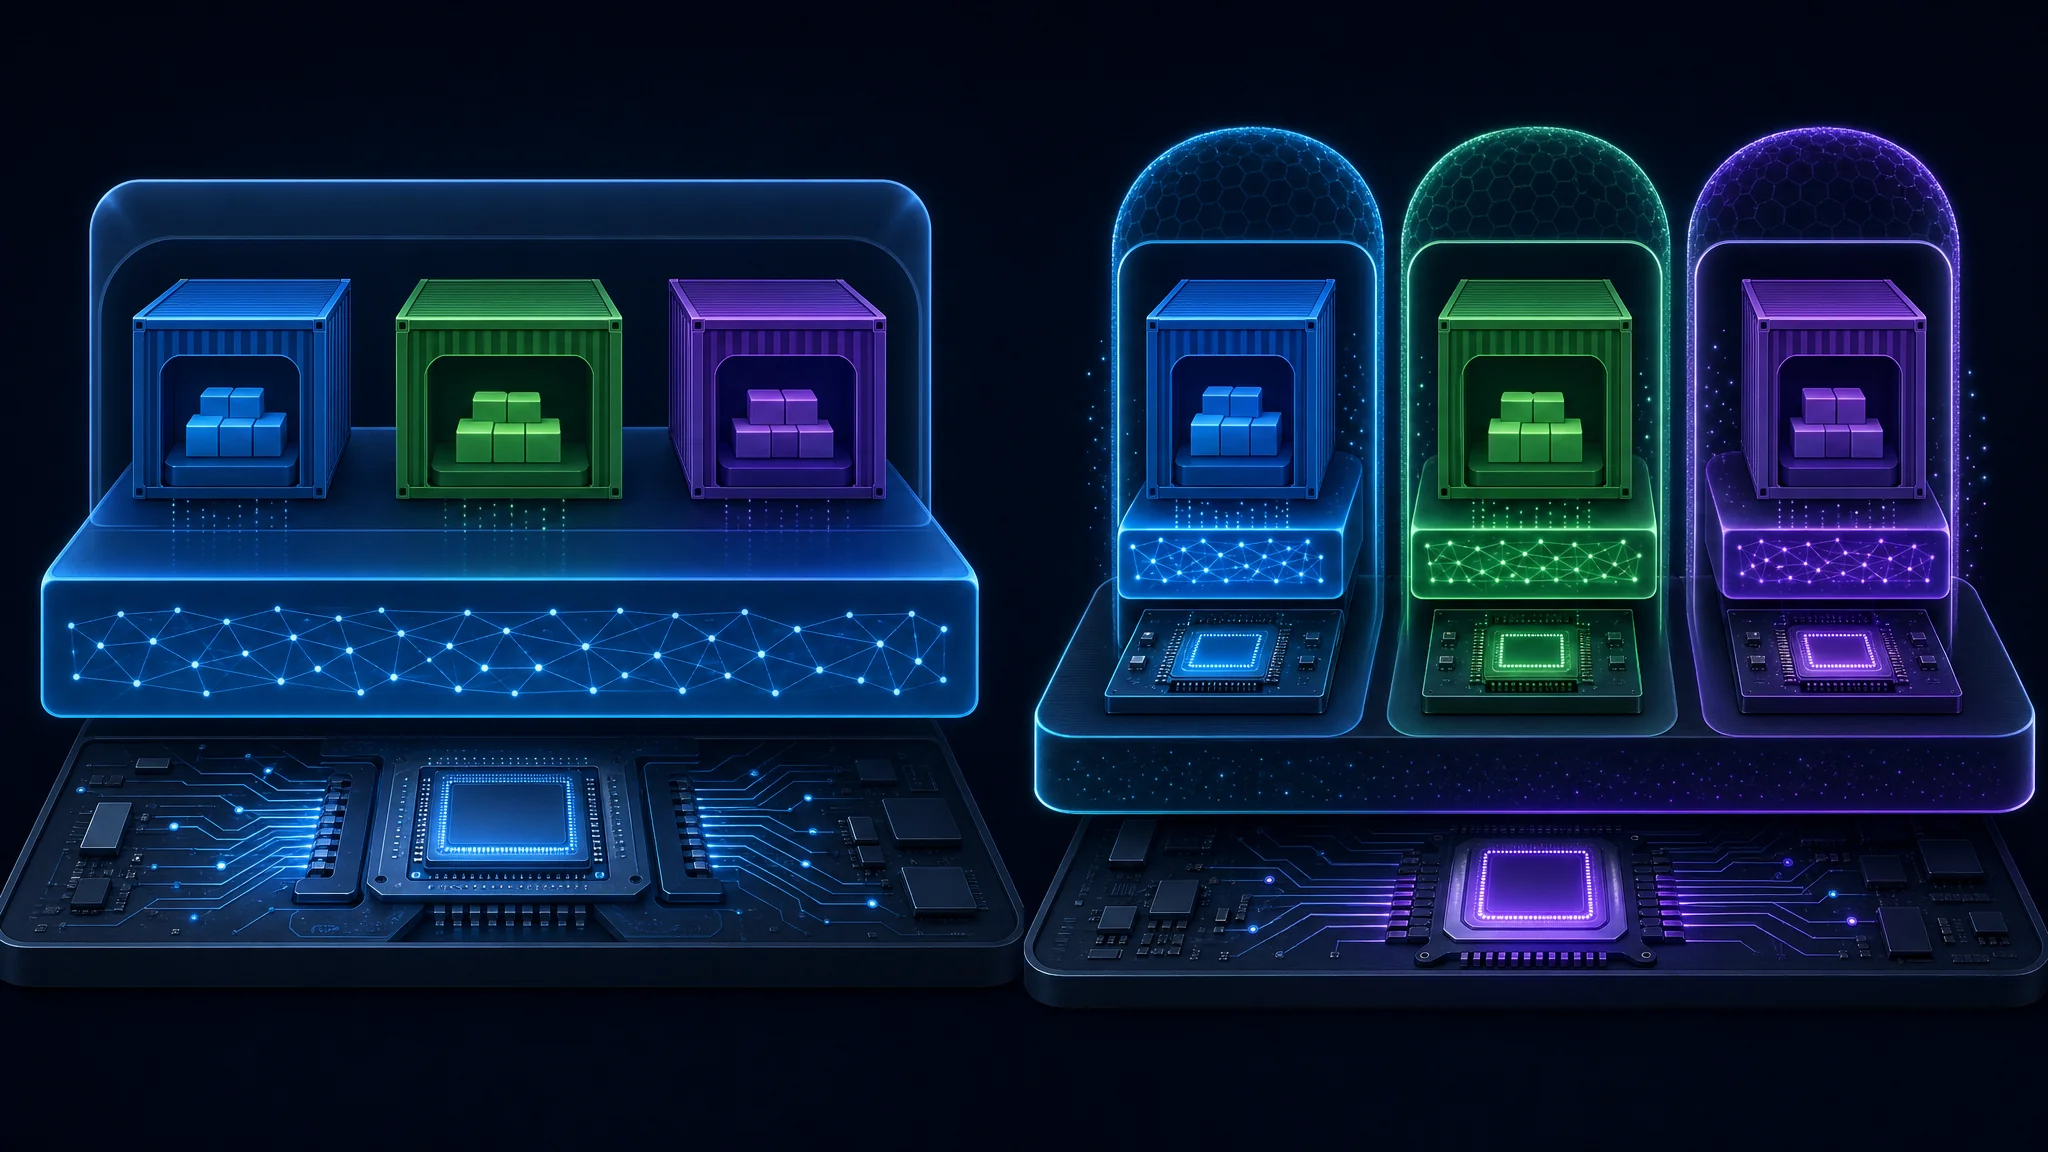
Una microVM da a cada carga de trabajo su propia instancia del kernel, que se ejecuta sobre virtualización impuesta por hardware en lugar de compartir el kernel del host mediante espacios de nombres.
La pila tiene tres capas que conviene nombrar:
- La CPU proporciona mecanismos de hardware para aislar una región de memoria de otra.
- KVM presenta esos mecanismos al kernel Linux, que así actúa como hipervisor.
- Un VMM (monitor de máquina virtual), como Firecracker o QEMU, controla KVM para crear y ejecutar el guest.
Como el guest ejecuta su propio kernel, un exploit del kernel dentro del guest solo compromete ese guest. No hay un kernel compartido que atacar. Luego, el atacante tendría que escapar del propio hipervisor, una superficie menor donde residen los fallos de KVM.
Dos implementaciones son importantes en la práctica y ambas aparecen en la recomendación de DepthFirst:
| Tecnología | Enfoque | Notas |
|---|---|---|
| Firecracker | VMM específico, modelo de dispositivos mínimo | Creado por AWS y diseñado para aislamiento multiinquilino a escala |
| Kata Containers | Runtime compatible con OCI que envuelve una microVM | Ejecuta imágenes estándar de contenedor con un límite de VM debajo |
Kata suele ser la migración más sencilla porque acepta las imágenes y herramientas de contenedor que ya se usan. Firecracker tiene una superficie de ataque menor, ya que implementa mucha menos emulación de dispositivos que un VMM de propósito general.
Qué hacer ahora
No todos los contenedores necesitan una microVM. La decisión depende de quién ejecuta el código dentro.
| Tu situación | Riesgo | Qué hacer |
|---|---|---|
| Ejecutas tu propio código, un solo inquilino | Bajo | Conserva los contenedores. Aplica parches enseguida, elimina capabilities y mantén el sistema de archivos raíz en solo lectura |
| Hosts multiinquilino, acceso shell para usuarios | Alto | Mueve las cargas no confiables a microVM. Es el primer caso que señala DepthFirst |
| Runners de CI que ejecutan PR no confiables | Alto | Una pull request se convierte en root en el runner. Aísla cada tarea en su propia VM |
| Notebooks, sandboxes de agentes, serverless | Alto | El código del inquilino se convierte en root del host. Usa una microVM por inquilino |
| Clústeres Kubernetes | Elevado | El host comparte la caché de páginas. Un pod con las primitivas adecuadas compromete el nodo y cruza límites entre inquilinos |
El principio común es simple. Los contenedores son excelentes herramientas de empaquetado y aislamiento de procesos. Nunca se diseñaron para contener código hostil, pero el sector los reutilizó para ese propósito porque eran prácticos y baratos.
Medidas de refuerzo útiles en cualquier caso
Nada de esto sustituye un límite de VM, pero elimina caminos fáciles:
# Disable the modules the page-cache family abuses, where they are not needed
printf 'install algif_aead /bin/false\ninstall esp4 /bin/false\ninstall esp6 /bin/false\ninstall rxrpc /bin/false\n' \
  > /etc/modprobe.d/harden-pagecache-family.conf
rmmod algif_aead esp4 esp6 rxrpc 2>/dev/null || true
# Restrict unprivileged user namespaces, which gates the ESP variants
# Debian and Ubuntu: this is a partial mitigation, not a complete one
sysctl -w kernel.unprivileged_userns_clone=0

# If exploitation is suspected, drop the page cache to discard modified in-memory binaries
echo 1 | tee /proc/sys/vm/drop_caches
# Detection starting points
- Unexpected unshare(CLONE_NEWUSER) from a workload with no legitimate reason
- NETLINK_XFRM activity, or XFRM security associations appearing outside IPsec hosts
- Requests to bind AF_ALG sockets
- Loads of esp4, esp6, or rxrpc on hosts running neither IPsec nor AFS
Aviso:
drop_cachesdescarta la copia modificada en memoria y elimina la corrupción, pero no expulsa a un atacante que ya obtuvo root. Trátalo como respuesta a incidentes, no como remediación.
El problema del ritmo de los parches
Incluso con las mejores intenciones, parchear el kernel se ha vuelto una carrera:
- Casi 6.000 CVE publicadas este año superan por volumen la mayoría de las ventanas de mantenimiento.
- Un parche introduce un fallo. Fragnesia lo demostró en este mismo subsistema.
- La lista de mitigaciones caduca.
algif_aeadera la respuesta en abril. En mayo no cubría nada de Dirty Frag.
La velocidad de parcheo es necesaria, pero insuficiente. La arquitectura decide si un parche omitido produce un incidente contenido o el compromiso del host.
La pregunta más difícil: ¿quién es el adversario?
La respuesta técnica está clara. La respuesta estratégica depende de una pregunta que la mayoría de los equipos omite.
Si tu modelo de amenazas incluye a un usuario curioso o un desarrollador descuidado, los contenedores siguen siendo adecuados. Escapar de un contenedor requiere ejecución local de código y un exploit del kernel. Ninguna es una tarea casual, y el costo operativo de moverlo todo a microVM es real.
Si tu modelo de amenazas incluye a un adversario que ejecuta código en tu infraestructura, los contenedores ahora son solo un obstáculo menor. Conviene citar la conclusión de DepthFirst en lugar de parafrasearla:
“La barrera de entrada para convertir estas vulnerabilidades en armas ha bajado tanto que debemos asumir que los atacantes ya pueden escapar de los contenedores estándar cuando quieran.”
Es un proveedor de seguridad con un producto que vender y que defiende una arquitectura concreta. El escepticismo es razonable. Pero el argumento no depende del proveedor. La cifra de 6.000 CVE es pública, los exploits están publicados y el kernel se comparte por diseño.
La formulación honesta: el valor del contenedor como límite disminuye ante un atacante con acceso inicial, pero permanece intacto ante todo lo demás.
Veredicto
Los contenedores siguen siendo la herramienta correcta para empaquetar, desplegar y separar procesos. Ya no son un límite de seguridad fiable frente al código hostil.
Tres afirmaciones, ordenadas por confianza:
La premisa técnica está establecida. Los contenedores comparten el kernel del host. Las cuatro vulnerabilidades de este artículo cruzaron el límite desde una cuenta sin privilegios, y los exploits son públicos.
La IA cambió el ritmo, no el principio. Las LPE del kernel siempre existieron. Ahora encontrar una cuesta cerca de una hora de escaneo con IA, en vez de meses de trabajo experto, y dos organizaciones encontraron el mismo zero-day por separado el mismo día.
Migrar tiene un costo, y no migrar también. Firecracker y Kata añaden sobrecarga, complejidad operativa y nuevas habilidades. La elección es directa: aceptar la sobrecarga o asumir que un fallo del kernel comprometa el host.
Si operas infraestructura multiinquilino o ejecutas código no confiable, empieza a planificar ahora la migración a microVM. No porque el cielo se esté cayendo, sino porque la trayectoria es clara y la migración lleva trimestres, no semanas.
Si ejecutas contenedores de un solo inquilino con tu propio código, consérvalos. Parchea el kernel más rápido que antes, desactiva módulos innecesarios y reconsidera la decisión cuando entre código no confiable.
La época de tratar el kernel como un límite de confianza incondicional está terminando. La infraestructura que asume que el kernel puede ser vulnerado es la que sobrevive.
Puntos clave
- Los contenedores comparten el kernel del host. El aislamiento procede de los espacios de nombres de
clone, no de la virtualización de hardware. Por tanto, un fallo del kernel afecta al contenedor. - Cuatro vulnerabilidades de 2026 cruzaron el límite desde cuentas locales sin privilegios: Copy Fail, Dirty Frag, Fragnesia y CVE-2026-80521. Todas atacan la caché de páginas.
- Hasta septiembre de 2026 se habían publicado casi 6.000 CVE del kernel, y las herramientas de IA aceleran los hallazgos. Copy Fail se encontró en aproximadamente una hora de escaneo con IA.
- Fragnesia fue introducida por el parche de Dirty Frag. El parche creó un nuevo fallo root en el mismo subsistema.
- La solución para Copy Fail no detiene Dirty Frag. Bloquear
algif_aeadcubre una vulnerabilidad y nada más de la familia. - CVE-2026-80521 también rompió
nsjail,FirejailyBubblewrap, no solo runtimes de contenedor. - Las microVM cambian el cálculo del riesgo porque dan a cada carga su propio kernel. KVM tiene fallos, pero su superficie es mucho menor.
- Elige según quién ejecuta el código. Tu código en un contenedor de un solo inquilino supone poco riesgo. El código no confiable en un host compartido puede comprometer el host.
Próximos pasos
- Lee el análisis del problema y el exploit publicado: Los contenedores ya no son un límite de seguridad - DepthFirst
- Consulta el aviso oficial y las medidas para Copy Fail: CERT/CC VU#260001
- Lee el análisis técnico de Dirty Frag para entender el encadenamiento y por qué falla la mitigación de
algif_aead: Análisis técnico de Dirty Frag - Consulta las reglas y recompensas de kvmCTF para ver la superficie de ataque del hipervisor: Descripción de kvmCTF
- Evalúa estas CVE en tu entorno con nuestra herramienta en el navegador: Calculadora CVSS v3.1
- Refuerza lo que ejecutas ahora: Cómo proteger tu entorno Docker y Kubernetes
- Entiende a fondo las compensaciones de aislamiento: Docker frente a máquinas virtuales 2026
- Reduce privilegios cuando no puedas añadir un límite: Control de acceso de mínimo privilegio en Linux
Artículos relacionados
| Artículo | Qué cubre |
|---|---|
| Docker frente a máquinas virtuales 2026 | La comparación arquitectónica que sustenta este artículo, con compensaciones de rendimiento y seguridad |
| Cómo proteger tu entorno Docker y Kubernetes | Endurecimiento práctico de la capa de contenedores, que sigue siendo útil dentro de una microVM |
| Docker en LXC sobre Proxmox: fiabilidad, evidencias y migración a VM | Contenedores anidados, evidencias y cuándo mover una carga a una VM completa |
| Entender la virtualización: conceptos y aplicaciones | Fundamentos del hipervisor, incluidas las funciones de CPU que requieren las microVM |
| Control de acceso de mínimo privilegio en Linux | Reducir los privilegios de una fuga para limitar su impacto |
Referencias
- Los contenedores ya no son un límite de seguridad - DepthFirst (Zhenpeng Lin, 22 de septiembre de 2026)
- CERT/CC Vulnerability Note VU#260001 - Copy Fail (CVE-2026-31431)
- Sitio oficial de divulgación de Copy Fail y análisis del exploit
- Análisis técnico de Dirty Frag - Hyunwoo Kim (CVE-2026-43284, CVE-2026-43500)
- Fragnesia: escalada local de privilegios en el kernel Linux mediante ESP-in-TCP - Wiz (CVE-2026-46300)
- Descripción de kvmCTF y niveles de recompensa - Google
- Entrada NVD para CVE-2026-31431
- Commit de corrección upstream mainline para Copy Fail
- Aviso de seguridad de Ubuntu sobre las correcciones de Copy Fail
- Exploits y envíos de KernelCTF - Google Security Research

This article refers to other articles we've written:
- Docker y máquinas virtuales: comparación de 2026
Comparación de 2026 entre contenedores Docker y máquinas virtuales según rendimiento, seguridad, coste, casos de uso y adecuación al despliegue.
- Cómo proteger su entorno Docker y Kubernetes
Conozca las mejores prácticas para proteger su entorno Docker y Kubernetes, incluido el uso de imágenes oficiales, la limitación de permisos y la implementación de la seguridad de red.
