2x RTX 5060 Ti frente a GB10: por qué 32 GB de VRAM pierden frente a 128 GB de memoria unificada
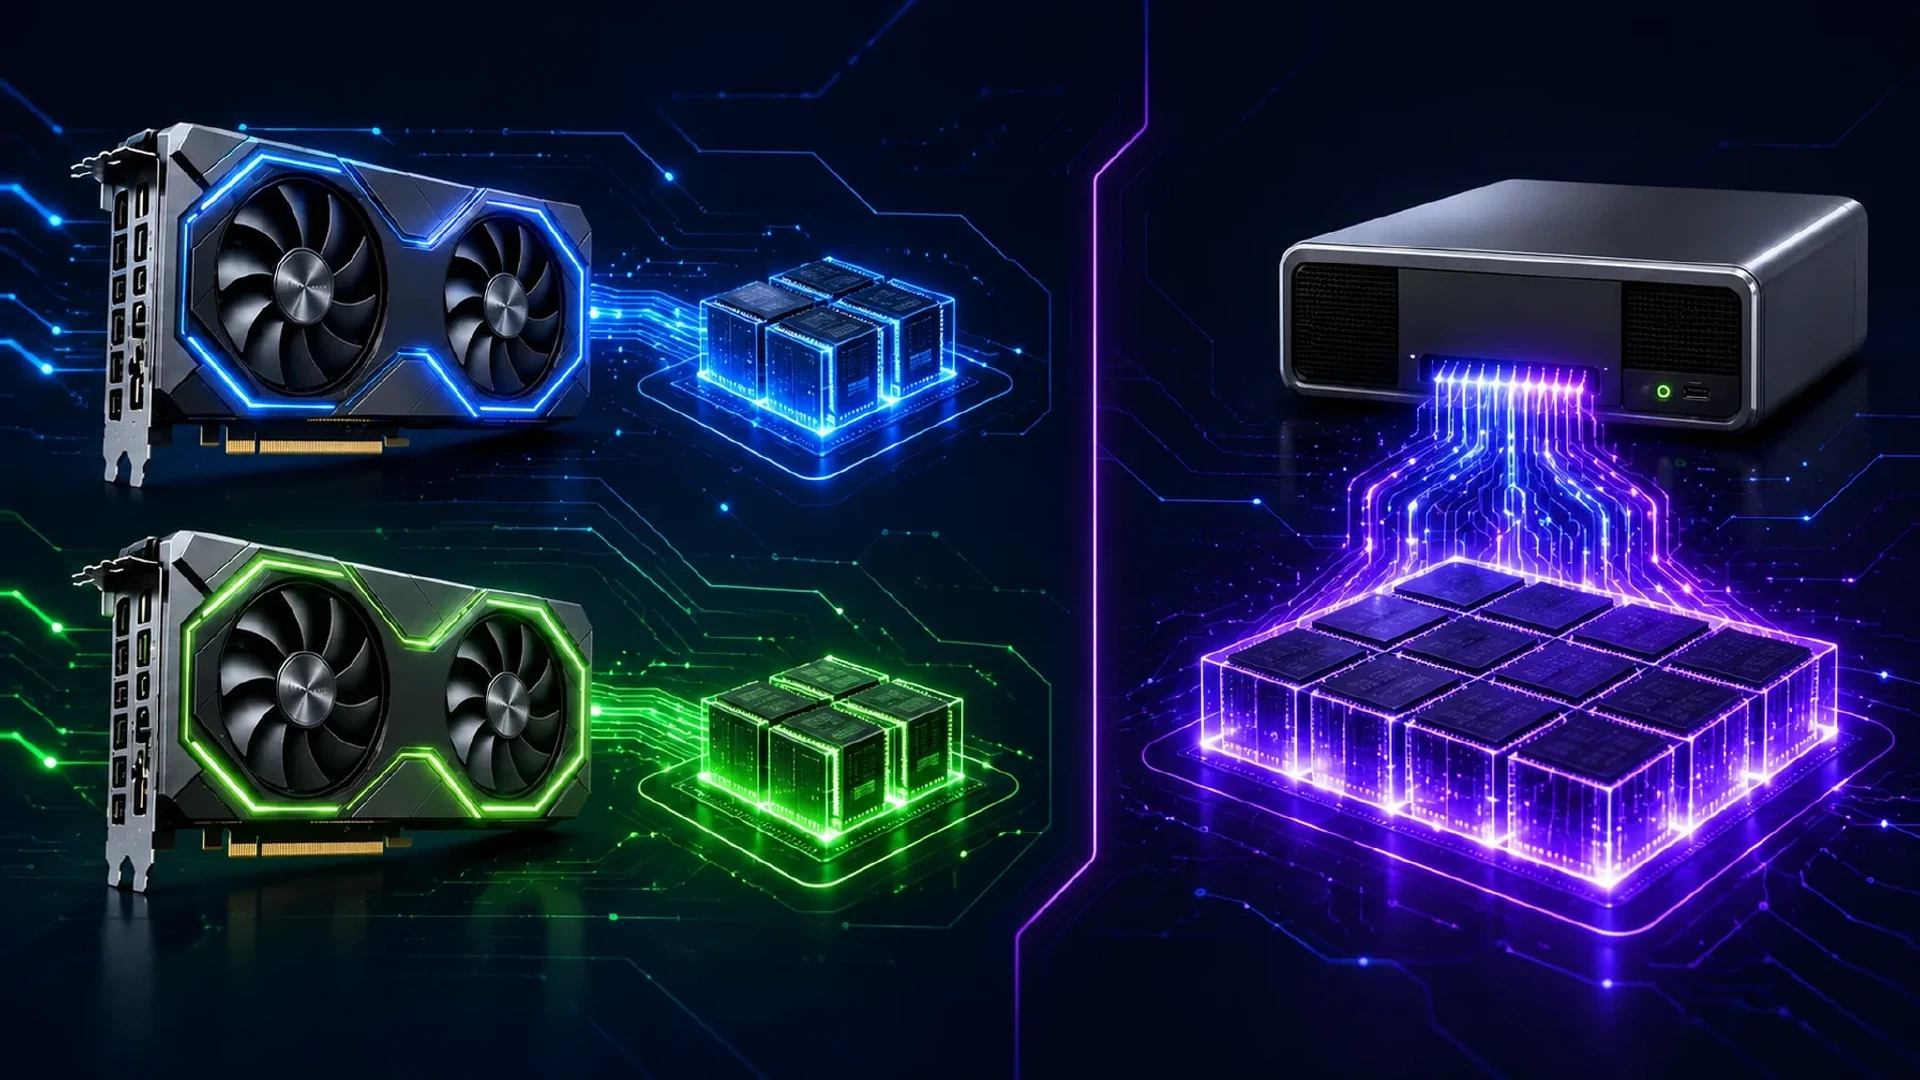
Table of Contents
Dos tarjetas RTX 5060 Ti de 16 GB parecen atractivas en una lista de componentes. Ofrecen 32 GB de VRAM agregada y buen procesamiento de prompts con contexto corto. La comparación cambia al ejecutar un modelo 27B con contexto largo.
El sistema NVIDIA GB10 usa 128 GB de memoria unificada coherente. NVIDIA indica 128 GB de memoria unificada LPDDR5x y una TDP de chip de 140 W para la plataforma GB10. La RTX 5060 Ti usa 16 GB de GDDR7 por tarjeta, una interfaz de memoria de 128 bits y una potencia gráfica total de 180 W. Las especificaciones de NVIDIA RTX 5060 Ti y las especificaciones de NVIDIA GB10 muestran la diferencia de hardware.
El punto es simple. Dos tarjetas de 16 GB no crean un pool rápido de 32 GB. Crean dos pools separados de 16 GB conectados mediante el sistema anfitrión. En inferencia de modelos grandes, la capacidad y el movimiento de datos entre dispositivos importan más que el número de tarjetas.
Comparación de memoria
| Sistema | Memoria | Modelo de memoria | Cifra de potencia indicada |
|---|---|---|---|
| 2x RTX 5060 Ti 16 GB | 32 GB agregados | Dos pools separados de memoria GPU | 360 W de GPU total |
| Sistema GB10 | 128 GB | Memoria de sistema unificada coherente | 140 W de TDP del GB10 |
GB10 no gana porque 128 GB de LPDDR5x igualen el ancho de banda de una GPU discreta de gama alta. La ventaja procede de la capacidad y la ubicación. CPU y GPU comparten el mismo espacio de direcciones. El modelo, los buffers de ejecución, las activaciones y los datos de contexto no tienen que caber en dos dispositivos aislados de 16 GB.
El sistema de dos tarjetas tiene un problema de ubicación más difícil. El modelo debe repartirse entre ambas. El runtime de inferencia debe mover datos entre ellas. El tráfico PCIe añade latencia y consume ancho de banda. NVIDIA indica además que la RTX 5060 Ti no admite NVLink.
Resultado del benchmark
Los siguientes resultados proceden del informe de benchmark de IA proporcionado. El informe compara un sistema dual-GPU sin nombre, llamado 5060ti-x2, con un sistema GB10. La prueba cubre Qwen y GPT-OSS con varios tamaños de contexto.
Los modelos llegaron directamente de Ollama. La prueba usó las etiquetas predeterminadas literales qwen3.8:27b y gpt-oss:latest, sin Modelfile personalizado ni cuantización alternativa. El sistema 5060ti-x2 usó PCIe Gen4 x16 y los controladores NVIDIA para Linux más recientes disponibles durante el benchmark.
Procesamiento de prompts y generación de Qwen
| Contexto | Prompt 5060ti-x2 tok/s | Generación 5060ti-x2 tok/s | Prompt GB10 tok/s | Generación GB10 tok/s |
|---|---|---|---|---|
| 4K | 862.5 | 56.9 | 57.4 | 27.7 |
| 16K | 917.3 | 53.5 | 62.1 | 28.1 |
| 32K | 881.4 | 48.8 | 62.4 | 26.9 |
| 64K | 795.1 | 39.6 | 59.9 | 26.1 |
| 128K | 538.7 | 28.3 | 59.9 | 28.6 |
| 256K | 189.9 | 1.2 | 59.9 | 25.8 |
En 4K, el sistema de dos tarjetas genera aproximadamente el doble de rápido que GB10. En 64K, la ventaja baja a unas 1,5 veces. En 128K, ambos sistemas alcanzan una velocidad de generación similar.
En 256K, la comparación deja de favorecer al equipo de dos tarjetas. La solicitud de 5060ti-x2 alcanzó solo 171.359 tokens de prompt reales. La generación cayó a 1,2 tokens por segundo. GB10 completó la prueba de 256K a 25,8 tokens por segundo.
GB10 generó unas 21,5 veces más rápido en el resultado probado de 256K. Más importante, GB10 completó el contexto solicitado. El sistema de dos tarjetas no entregó la misma carga.
Por qué la VRAM agregada resulta engañosa
1. El modelo no ve una tarjeta de 32 GB
Dos GPU no fusionan su memoria en un único espacio de direcciones local. Un runtime paralelo divide capas o tensores entre dispositivos. Cada dispositivo sigue necesitando espacio para sus pesos asignados, buffers temporales y parte del estado de contexto.
La capacidad utilizable queda por debajo de la suma simple. La sobrecarga exacta depende del formato del modelo, la cuantización, el backend de inferencia, la división de tensores y la longitud del contexto.
2. La memoria de contexto crece durante la generación
Los pesos son solo una parte del presupuesto de memoria. La caché de claves y valores, o KV cache, guarda datos de atención de tokens anteriores. Los contextos largos requieren más caché. Una prueba de 4K no predice un despliegue de 128K o 256K.
Los resultados muestran este límite. El sistema de dos tarjetas conserva una ventaja de procesamiento de prompts y luego pierde rendimiento de generación al crecer el contexto. GB10 se mantiene cerca de 26 a 29 tokens de generación por segundo entre 4K y 256K.
3. Las transferencias PCIe añaden un coste
Cuando el runtime mueve activaciones o tensores entre GPU, la transferencia cruza la interconexión del host. Esto crea puntos de sincronización y añade latencia a cada paso. La penalización crece cuando la carga cruza repetidamente la frontera entre dispositivos.
Esto no vuelve inútil un sistema dual-GPU. La ubicación de memoria forma parte del resultado de rendimiento. Un benchmark que informa solo del procesamiento de prompts en 4K omite este coste.
4. La eficiencia energética es una ventaja del sistema
GB10 usa menos energía en la comparación y ofrece más capacidad para la carga de contexto largo probada. Dos RTX 5060 Ti suman 360 W de potencia de GPU antes del resto del sistema. NVIDIA indica 140 W de TDP para GB10.
GB10 cambia velocidad máxima con contexto corto por capacidad, finalización y menor potencia de GPU. Esas compensaciones importan en inferencia Qwen con contexto largo.
El sistema 5060ti-x2 cuesta mucho menos
La comparación de rendimiento no elimina la diferencia de precio. Una estación de trabajo completa con dos RTX 5060 Ti de 16 GB aparecía a 3.479 dólares el 10 de octubre de 2026. Incluye Intel Ultra 7 265K, placa Z890, 32 GB de DDR5, 1 TB de almacenamiento, fuente de 1.000 W y ambas GPU. Ver la estación de trabajo dual-GPU completa .
El marketplace estadounidense de NVIDIA lista la DGX Spark de 128 GB a 6.950 dólares. Incluye 128 GB de memoria unificada coherente y 4 TB NVMe, pero aparece sin existencias. Consultar la lista actual de DGX Spark de NVIDIA .
La AMD Ryzen AI Halo Developer Platform aporta otro punto de comparación. Este sistema Strix Halo cuesta 3.999,99 dólares en Micro Center, con 128 GB de memoria unificada LPDDR5x y 2 TB de almacenamiento. Strix Halo suele pertenecer a la misma clase práctica de IA local que GB10, aunque las pruebas independientes suelen medir a GB10 por delante en rendimiento y madurez del software. Consultar la lista Linux actual de Micro Center y leer la reseña de Strix Halo frente a GB10 .
| Sistema completo | Precio listado el 10 de octubre de 2026 | Diferencia de precio |
|---|---|---|
| Estación 5060ti-x2 | $3,479 | Base |
| AMD Ryzen AI Halo, Strix Halo | $3,999.99 | $520.99 más |
| GB10 DGX Spark de 128 GB | $6,950 | $3,471 más |
GB10 ofrece un pool unificado mayor, menor consumo y mejor arquitectura para contexto largo. El sistema AMD ofrece la misma clase de 128 GB por unos 4.000 dólares. La estación 5060ti-x2 sigue en 50% del precio listado de GB10, antes de impuestos y envío. Quien necesite memoria unificada sin el stack de software de NVIDIA tiene una alternativa más barata en Strix Halo.
Son precios de distintos vendedores, no una cesta minorista controlada. La comparación también deja al 5060ti-x2 con menos memoria de sistema y almacenamiento. La diferencia importa porque ambas listas describen ordenadores completos y utilizables, no precios de GPU sueltas. Las tarjetas RTX 5060 Ti de 16 GB rondan 789 a 830 dólares cada una, muy por encima del MSRP de lanzamiento de 429 dólares. La ventaja de precio de dos tarjetas continúa durante el aumento actual de precios de GPU. Precios actuales de RTX 5060 Ti .
El resultado de GPT-OSS requiere un tratamiento separado
El mismo informe muestra una generación fuerte de GPT-OSS en 5060ti-x2 entre 4K y 256K. GB10 completa las pruebas de 4K a 128K, pero la prueba GPT-OSS de 256K aparece como no compatible.
No uses la tabla GPT-OSS para declarar un ganador universal. Las pruebas no cubren el mismo rango en 256K. Qwen ofrece la comparación de contexto largo más limpia porque ambos sistemas informan un resultado de 256K, aunque la ejecución 5060ti-x2 alcanzó solo 171.359 tokens de prompt reales.
Qué significa para un equipo Qwen 3 27B
Una configuración de dos tarjetas de 16 GB podría ejecutar un modelo 27B cuantizado con un contexto menor. El benchmark no refuta este uso. Los datos refutan la afirmación de que 32 GB de VRAM agregada ofrecen el mismo margen práctico que 128 GB de memoria unificada.
Que un modelo quepa en una tarjeta demuestra solo capacidad para los pesos. El requisito real incluye pesos, contexto activo, KV cache, buffers de ejecución y margen del sistema operativo. El contexto debe caber junto al modelo. Un modelo que carga sin espacio para la conversación de trabajo no es una configuración útil de contexto largo.
Esto coincide con la guía de dimensionamiento de ¿Bastan 16GB de VRAM para trabajar en serio con LLM locales? , que trata pesos, contexto y asignaciones del runtime como un presupuesto. La guía de 32GB de VRAM para Qwen 27B llega a la misma conclusión para equipos de dos tarjetas. Capacidad agregada no equivale a margen utilizable.
Antes de comprar hardware para Qwen 3 27B, responde cuatro preguntas:
- ¿La cuantización solicitada cabe con los buffers del runtime? Los pesos solos no definen la memoria necesaria.
- ¿Cabe el contexto sin presión grave sobre la KV cache? Los prompts largos cambian el resultado.
- ¿Usa el runtime una división rápida de dispositivos? Las transferencias PCIe y la ubicación de tensores afectan cada token generado.
- ¿El sistema completa el contexto objetivo? Un resultado rápido en 4K no compensa una carga fallida en 256K.
La prueba proporcionada responde a la última pregunta para el sistema de dos tarjetas. La ejecución llegó a 171.359 tokens durante la solicitud Qwen de 256K y generó a 1,2 tokens por segundo. GB10 completó 256K a 25,8 tokens por segundo.
Para esta carga de contexto largo, la memoria unificada es la mejor arquitectura cuando la alternativa depende de PCIe para abarcar el conjunto de trabajo del modelo. PCIe sigue siendo una solución de capacidad. No crea el mismo pool, latencia ni ruta de transferencia. La guía de contexto de GPU para IA local explica por qué pesos, KV cache, salida de herramientas y buffers deben dimensionarse juntos. El benchmark de GPU de Ollama Qwen3.8 27B también explica por qué los resultados de contexto largo requieren atención separada de las cifras de decodificación con contexto corto.
Veredicto
Dos RTX 5060 Ti de 16 GB son un sustituto pobre de GB10 para inferencia 27B con contexto largo. Ofrecen mayor rendimiento de prompts con contextos cortos. También consumen más potencia de GPU y exponen al runtime a una memoria dividida.
GB10 procesa prompts más despacio en los resultados proporcionados. El sistema es más eficiente, ofrece cuatro veces la memoria agregada y completa la prueba Qwen de 256K con una velocidad de generación útil.
Si ejecutas prompts cortos y valoras la ingestión de prompts, 5060ti-x2 tiene un caso limitado. Para un modelo 27B, el pool unificado mayor es mejor porque modelo y contexto comparten un conjunto de trabajo coherente. La memoria unificada sigue siendo preferible cuando las transferencias PCIe entran en la ruta de inferencia.
El benchmark no demuestra que dos RTX 5060 Ti nunca inicien Qwen 3 27B. Los datos muestran por qué iniciar el modelo difiere de ejecutar bien la carga.
Límites del benchmark
El informe identifica las etiquetas literales de Ollama, pero no registra los digest de manifiesto resueltos, revisiones del modelo, CPU, mediciones de potencia ni refrigeración. También identifica PCIe Gen4 x16 para 5060ti-x2 y los controladores NVIDIA Linux actuales durante la prueba. Trata las cifras como una comparación de sistemas observados, no como una clasificación universal de cada par de RTX 5060 Ti y cada implementación GB10.
Las especificaciones de hardware proceden de NVIDIA. Las cifras de rendimiento proceden de los datos de benchmark proporcionados para este artículo.
Referencias
- Biblioteca de modelos Qwen3.8 de Ollama
- Etiquetas de modelos GPT-OSS de Ollama
- ¿Bastan 16GB de VRAM para trabajar en serio con LLM locales?
- 32GB de VRAM para Qwen 27B
- Guía de contexto de GPU para IA local
- Benchmarks de GPU de Qwen3.8 27B en Vast.ai
- Estación completa con dos RTX 5060 Ti de 16 GB
- Lista de NVIDIA DGX Spark en el marketplace estadounidense
- Lista Linux AMD Ryzen AI Halo de 128 GB
- Reseña de Tom’s Hardware sobre Strix Halo frente a GB10
- Precios actuales de RTX 5060 Ti
Related Posts